데이터베이스 Lock에 대한 기본과 더 나아가서 Lock을 효율적으로 획득, 해지하는 알고리즘인 Two-Phase Locking 에 대해서도 알아봤습니다. 이 글에서는 Lock 단위 세분화가 갖는 Trade-off 와 Trade-off 에서 장점을 극대화하기 위한 장치인 의도 락과 MGL에 대해서 알아보겠습니다.
이 글을 상당 부분은 Jim Gray의Granularity of Locks and Degrees of Consistency in a Shared Data Base에 기반합니다.
락을 세분화하라(Lock Granularity)
2PL은 "어떻게" 락을 획득하고 해제할 것인가에 대한 답을 주었습니다. 이제는 "어디에" Lock을 걸것이냐를 생각해야합니다.
Lock 단위
그런데 Lock을 어디에 것이냐라는 질문에 앞서 데이터베이스에서 Lock을 걸 수 있는게 뭐가 있지? 라는 질문이 떠오릅니다.
그 질문에 대한 답을 아래의 그림에 정리했습니다.
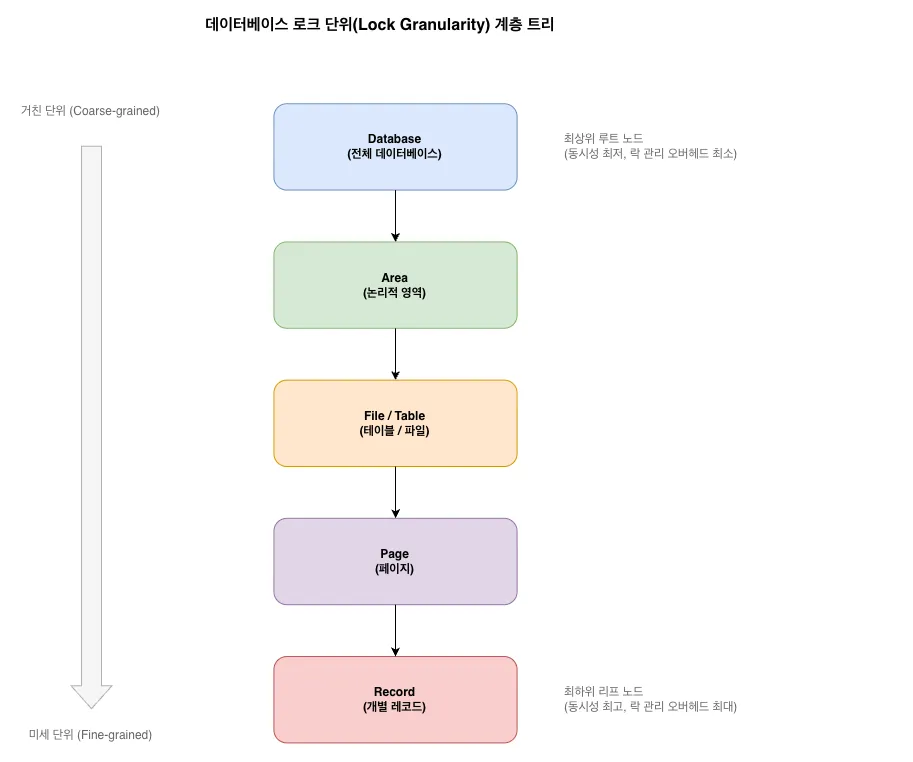
- 데이터베이스 (Database): 트리의 최상위 루트 노드로 전체 데이터베이스를 상징합니다.
- 영역 (Area): 데이터베이스 하위의 논리적 영역입니다.
- 파일 / 테이블 (File / Table): 파일 또는 테이블 단위 계층입니다.
- 페이지 (Page): 테이블 하위의 물리적/논리적 페이지 단위입니다.
- 레코드 (Record): 트리의 최하위 리프 노드로 개별 레코드를 의미합니다.
Lock 단위에 따른 Trade-off
락 단위 설정은 근본적으로 동시성(Concurrency)과 락 관리 오버헤드(Overhead) 사이의 상충 관계(Trade-off)를 갖습니다.
- 극단적으로 미세한 단위(Fine-grained): 즉 개별 레코드(Record)나 필드 수준에서 락을 적용할 경우, 여러 트랜잭션이 동일한 테이블의 서로 다른 레코드에 동시에 접근할 수 있으므로 동시성은 극대화됩니다. 그러나 수만 건의 레코드를 일괄 업데이트하는 복잡한 트랜잭션이 미세 단위 락을 사용할 경우, 수만 개의 락 객체를 생성하고 추적하기 위한 메모리 소비와 락 매니저(Lock Manager)의 CPU 연산 오버헤드가 기하급수적으로 폭증하여 시스템이 마비될 수 있겠죠.
- 반대로 극단적으로 거친 단위(Coarse-grained): 즉 전체 파일(File)이나 테이블(Table) 수준에서 락을 적용할 경우, 락 매니저는 단 하나의 락 객체만 관리하면 되므로 오버헤드는 거의 발생하지 않게됩니다. 하지만 단일 레코드만 수정하려는 간단한 트랜잭션조차 거대 테이블 전체에 락을 걸게 되므로, 테이블 내의 다른 모든 레코드에 대한 타 트랜잭션의 접근이 전면 차단되어 시스템의 동시 처리는 사실상 불가능해집니다.
| 레코드 단위 X 락 | 테이블 단위 X 락 |
| T1이 R1에 X 락을 보유 | T1이 테이블 전체에 X 락을 보유 |
| T2는 R2에 X 락을 얻어 수정 가능 | T2는 R2를 수정하려 해도 대기 |
| 많은 행을 수정하면 관리할 락이 많아짐 | 넓은 범위를 적은 락으로 보호 |
이러한 Trade-off 때문에 Lock 단위를 하나로 통일할 수 없습니다. 다양한 락 단위가 공존해야한 이러한 딜레마를 해결할 수 있습니다.
MGL(Multiple Granularity Locking)의 등장
다양한 Lock 단위가 공존해야한다는 사실에 의거하여 다중 단위 락(Multiple Granularity Locking, MGL)이라는 프로토콜이 체계화되었습니다.
MGL의 기본 철학은 트랜잭션이 상위 계층의 특정 노드에 Lock을 획득하면, 그 노드의 하위 자손 노드들에 대해서도 암묵적(Implicit)으로 동일한 Lock이 걸린것으로 간주하는 것입니다. 예를 들어 특정 파일 노드에 X-Lock을 획득하면, 해당 파일에 속한 수백만 개의 Record에 대해 일일이 Lock을 걸지 않아도 전체 레코드가 베타적으로 잠긴 효과를 냅니다.
하지만 암묵적 Lock 방식은 심각한 충돌 감지 문제를 유발하는데요. 예를 들어 트랜잭션 T1이 특정 리프노드의 Record R1에 미세단위 Lock을 걸어놓은 상태에서, 트랜잭션 T2가 테이블 전체에 Coarse-grained Lock 을 걸려고 시도한다면, T2은 Lock을 승인받기 전에 하위 계층의 모든 Record를 모두 순회하며 Lock 점유 여부를 검사해야합니다. 이때 탐색비용이 O(N)이 되어 MGL의 유용성에 큰 의문점이 제기됩니다.
여기까지 읽으면 의문이 듭니다. MGL이라는게 도대체 뭐가 다른거지? 상위 노드에 Lock을 걸면 하위 노드까지 Lock이 걸린걸로 간주하는 암묵적인 Lock이 있으면 어차피 Trade-off는 그대로인것 같고, 하위 Recrod에 Lock을 걸면 또 탐색해야해서 탐색비용이 존재한다니 사실 MGL 개념 자체로는 어떤 문제도 해결하지 못합니다.
의도 락(Intention Lock)의 탐색비용 해결
MGL은 탐색비용 문제를 해결하기 위해 의도 락(Intention Lock)이라는 메타데이터를 활용하기로 합니다. 의도 잠금은 특정 노드에 대해 직접적인 읽기나 쓰기 권한을 부여하지 않는 대신, "나의 하위 자손 노드 중 어딘가에 실제 명시적 락(Explicit Lock)을 획득할 의도가 있다"는 표지판 역할을 합니다.
데이터베이스 Lock 시리즈 첫글에 등장했던 의도락에 대한 설명입니다.
- IS (Intent Shared): 트랜잭션이 조만간 하위 계층의 노드 중 일부에 공유 락(S-Lock)을 획득하여 읽기 작업을 수행할 것임을 선언합니다.
- IX (Intent Exclusive): 트랜잭션이 하위 계층 노드 중 일부에 배타 락(X-Lock)을 획득하여 데이터 수정 작업을 수행할 것임을 선언합니다.
- SIX (Shared and Intent Exclusive): S 락과 IX 락이 결합된 형태로, 테이블 전체를 스캔(S 락)하면서 조건에 맞는 일부 레코드만 수정(IX 락)하는 배치 작업 등에서 락 처리 효율성을 높이기 위해 사용됩니다.
트랜잭션은 트리의 하위 노드에 명시적 락(S 혹은 X)을 걸기 위해서 앞선 조상 노드들에게도 의도 락을 순차적으로 획득해야합니다. 이러한 의도 락 체계가 도입됨에 따라 탐색 문제가 완벽하게 해결됩니다. 테이블에 Lock을 걸려고 시도했던 T2는 이제 테이블 노드에 누군가가 IS나 IX를 걸어두었는지만 확인하면 되기 때문입니다. 시간복잡도 O(1)로 하위 노드 충돌 여부를 정확히 판단하고 대기열로 트랜잭션을 이동시킬 수 있습니다.
의도 락(Intention Lock)의 동시성 성능 해결
탐색 비용을 O(1)로 줄인 것은 훌륭하지만, 처음에 가졌던 의문이 하나 남아있습니다. "결국 레코드에 접근하기 위해 테이블이라는 상위 노드에 락을 걸어버리면, 다른 트랜잭션이 해당 테이블에 접근하지 못해서 동시성이 떨어지는 것 아닌가요?"
이 질문에 대한 해답은 MGL의 락 호환성(Lock Compatibility) 규칙에 숨어있습니다.
| 기 점유 잠금 \ 신규 요청 잠금 | IS (의도 공유) | IX (의도 배타) | S (공유) | SIX (공유+의도 배타) | X (배타) |
| IS (의도 공유) | 호환됨 | 호환됨 | 호환됨 | 호환됨 | 충돌 |
| IX (의도 배타) | 호환됨 | 호환됨 | 충돌 | 충돌 | 충돌 |
| S (공유) | 호환됨 | 충돌 | 호환됨 | 충돌 | 충돌 |
| SIX (공유+의도 배타) | 호환됨 | 충돌 | 충돌 | 충돌 | 충돌 |
| X (배타) | 충돌 | 충돌 | 충돌 | 충돌 | 충돌 |
위 표를 보면 알 수 있겠지만같은 의도 락끼리는 서로 충돌하지 않습니다. S-Lock 과 X-Lock 혹은 X-Lock 과 X-Lock이 충돌했던 것과는 사뭇 다릅니다.
이러한 특성을 보여주기 위해 두 개의 트랜잭션이 동일한 테이블의 서로 다른 레코드를 수정하려는 상황을 가정해 보겠습니다.
- 트랜잭션 A가 1번 레코드를 수정하기 위해 테이블 계층에 IX 락을 겁니다.
- 트랜잭션 B가 2번 레코드를 수정하기 위해 동일한 테이블 계층에 IX 락을 요청합니다.
일반적인 배타 락(X-Lock)이었다면 트랜잭션 B는 대기열로 밀려났겠지만, 락 매니저는 테이블 수준에서 두 트랜잭션의 IX 락 요청을 모두 승인합니다. 테이블 계층에서는 서로 통행을 허용하여 동시성을 완벽하게 유지하고, 진짜 데이터 충돌 여부에 대한 판단은 최하위 노드인 레코드 레벨(Row-level)의 X 락 충돌 검사로 위임(Delegation)하는 것입니다.
심지어 읽기 의도를 나타내는 IS 락과 쓰기 의도를 나타내는 IX 락도 상위 계층에서는 서로 호환됩니다. 누군가 테이블의 일부를 읽고(IS) 있고, 누군가 테이블의 일부를 쓰고(IX) 있더라도, 그 일부가 물리적으로 겹치지만 않는다면 모순이 발생하지 않기 때문입니다.
결과적으로 의도 락은 상위 노드의 병목 현상을 피하면서도, 누군가 테이블 전체를 잠그려는 거친 단위의 락(테이블 X 락 등)을 요청했을 때 즉각적으로 충돌을 감지할 수 있는 완벽한 중재자 역할을 해냅니다.
락 에스컬레이션(Lock Escalation) 매커니즘
이렇게 의도 락을 통해 레코드 단위로 정밀하게 락을 걸어 동시성을 극대화하다 보면, 글의 서두에서 언급했던 "락 매니저의 오버헤드 폭증" 문제가 다시 고개를 듭니다. 단일 트랜잭션이 수만 개의 레코드를 한 번에 업데이트한다면, 수만 개의 락(Lock) 객체를 추적하고 관리하기 위해 시스템의 메모리와 CPU가 심각하게 고갈될 수 있습니다.
이때 MGL의 계층 구조가 또 다른 진가를 발휘합니다. DBMS는 특정 트랜잭션이 보유한 락의 개수나 메모리 점유율이 시스템이 설정한 임계치를 넘어서면, 락 에스컬레이션(Lock Escalation)이라는 방어 기제를 발동시킵니다.
락 매니저는 하위 노드(레코드)들에 잘게 쪼개져 걸려있던 수많은 락을 모두 취소하고, 이를 상위 노드인 테이블 레벨의 거친 락(Table-level Lock) 하나로 병합하여 승격시켜버립니다. 물론 에스컬레이션이 발생하여 테이블 전체가 잠기면 타 트랜잭션의 접근이 차단되어 동시성은 일시적으로 마비되지만, 시스템 전체가 다운되는 치명적인 장애를 막아주는 필수적인 훌륭한 안전장치로서 기능하는 것입니다
락 매니저(Lock Manager), 엔지니어링의 정수
MGL, 의도 락, 의도 락 호환성, 락 에스컬레이션 너무 좋은 이야기입니다. 덕분에 동시성 성능과 락 매니저의 오버헤드를 효과적으로 관리할 수 있게 된것 같습니다. 하지만 사실은 그렇지 않습니다. 2PL에 따른 단계 조정과 MGL 구현의 책임은 이제 락 매니저에게 떠넘겨졌습니다.
이론적으로 2PL과 MGL이 아무리 완벽하더라도, 초당 수만 번씩 쏟아지는 트랜잭션의 락 획득 요청과 반납, 그리고 복잡한 호환성 검사를 지연 없이 처리하는 것은 전적으로 락 매니저(Lock Manager)의 몫입니다. 락 매니저는 이 막대한 부하를 견디기 위해 극도로 최적화된 자료구조를 사용합니다.
해시 테이블과 대기열(Queue)
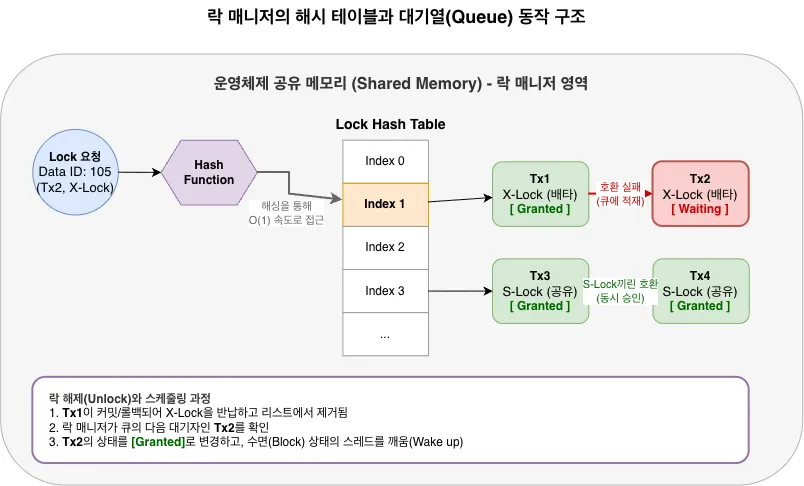
락 매니저의 핵심 두뇌는 주 메모리(In-memory)에 상주하는 거대한 해시 테이블(Hash Table)입니다. 특정 데이터 항목에 접근하려는 트랜잭션이 발생하면, 락 매니저는 해당 데이터의 고유 식별자(ID)를 해싱하여 즉시 락 테이블의 특정 위치로 찾아갑니다.
아래의 그림과 같이 해시 테이블의 각 공간에는 연결 리스트(Linked List) 형태의 큐(Queue)가 매달려 있습니다.
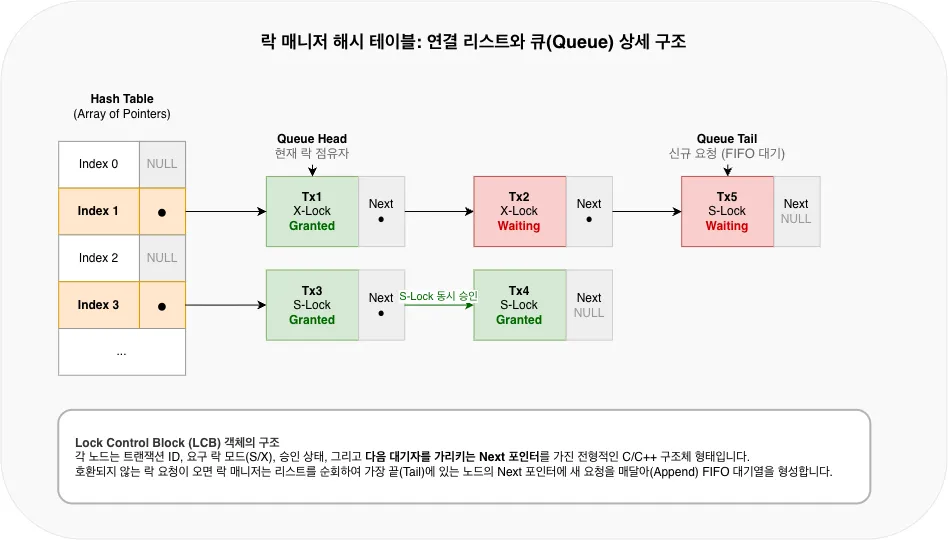
누군가 락을 요청하면 락 매니저는 이 큐를 검사합니다. 만약 큐가 비어있거나 기존에 부여된 락과 호환된다면, 즉시 상태를 승인(Granted)으로 기록하고 통과시킵니다. 하지만 호환되지 않는 배타 락(Write Lock) 등이 선점되어 있다면, 해당 트랜잭션을 큐의 맨 뒤에 대기(Waiting) 상태로 매달아 두고 수면(Block) 상태로 만듭니다.
이후 활성화되어 있던 트랜잭션이 커밋(Commit)되거나 롤백(Rollback)되어 락을 해제하면, 락 매니저는 즉각적으로 큐에서 다음 대기자를 깨워 락을 부여하는 막중한 스케줄링 작업을 쉴 새 없이 수행합니다.
락 스레싱(Lock Thrashing)의 해법, 파티셔닝과 패스트 패스
이전 글에서 말한것 처럼 이러한 해시 테이블이 글로벌 공유 메모리에 위치할 경우 수십 개의 CPU 코어가 단일 해시 테이블을 보호하는 상호 배제(Mutex) 래치나 스핀락(Spinlock)을 쟁취하기 위해 무한 루프를 돌며 경합하게 되고, 이때 CPU 캐시 라인이 지속적으로 무효화되는 현상이 발생합니다. 즉, 락 상태를 동기화하는 데에만 사이클을 낭비하는 락 스레싱(Lock Thrasing)상태에 빠지게 되는 것입니다.
현대 상용 DBMS는 이 거대한 단일 병목 지점을 해소하기 위해 컴퓨터 아키텍처 관점의 정교한 해결책을 도입했습니다.
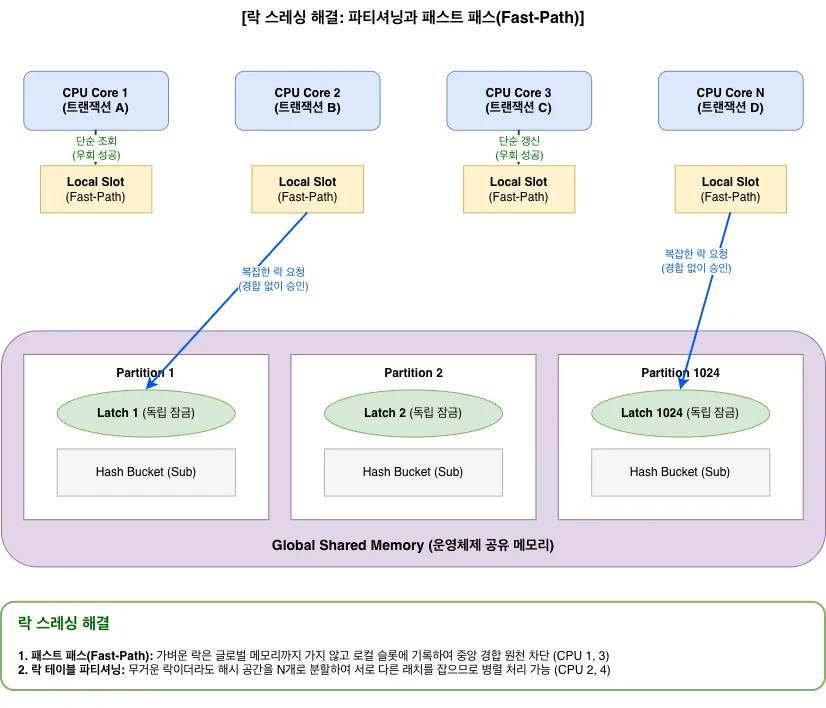
첫째, 락 테이블 파티셔닝(Lock Space Partitioning)입니다. 거대한 해시 테이블 전체를 하나의 자물쇠(글로벌 래치)로 잠그는 대신, 락 공간을 수많은 파티션(예: PostgreSQL의 1024개 배열 카운터)으로 잘게 쪼개어 각 파티션마다 독립적인 래치를 부여합니다. 이렇게 하면 서로 다른 해시 공간에 접근하는 트랜잭션들이 래치 경합 없이 완벽히 병렬로 락을 획득할 수 있습니다.
둘째, 패스트 패스 로킹(Fast-Path Locking)입니다. 단순 SELECT 쿼리나 일반적인 DML 수행 시 발생하는 가벼운 수준의 락(Weak Locks)은 굳이 경합이 심한 중앙 메인 해시 테이블까지 찾아가지 않습니다. 대신 각 트랜잭션(백엔드 프로세스)에게 할당된 별도의 독립적인 로컬 메모리 슬롯(빠른 경로)에 락 정보를 즉시 기록하여 중앙 시스템의 경합을 원천적으로 우회합니다. 이러한 고도의 최적화 기법들이 락 스레싱을 막아주는 방패 역할을 수행합니다. 이 기반 위에서 활성화되어 있던 트랜잭션이 커밋(Commit)되거나 롤백(Rollback)되어 락을 해제하면, 락 매니저는 즉각적으로 큐에서 다음 대기자를 깨워 락을 부여하는 막중한 스케줄링 작업을 지연 없이 쉴 새 없이 수행할 수 있게 되는 것입니다.
교착 상태(Deadlock)와의 끝없는 전쟁
하지만 락 매니저가 대기열을 아무리 정교하게 관리하더라도, 락을 쥐고 대기하는 2PL 환경에서는 치명적인 논리적 결함이 하나 발생합니다. 바로 트랜잭션들이 서로의 락이 풀리기만을 영원히 기다리는 교착 상태(Deadlock)입니다. 예를 들어 트랜잭션 A가 자원 1을 쥐고 자원 2를 대기하는데, 동시에 트랜잭션 B가 자원 2를 쥐고 자원 1을 대기한다면 두 트랜잭션은 순환 의존성(Circular Dependency)의 늪에 빠져 영원히 멈춰버립니다.
이 교착 상태를 방치하면 뒤이어 들어오는 수많은 트랜잭션까지 큐에 쌓이면서 시스템 전체가 마비됩니다. 따라서 락 매니저는 데드락을 통제하기 위해 탐지(Detection)와 회피(Prevention) 전략을 구사합니다.
1. 교착 상태 탐지 (Detection) 및 복구: 락 매니저가 백그라운드에서 주기적으로 대기 그래프(Waits-for Graph)를 그려 순환 사이클이 형성되었는지 사후에 확인하는 방식입니다. 교착 상태가 발견되면 연산 비용이나 롤백 비용이 가장 적은 트랜잭션을 강제로 종료시키고 얽힌 고리를 끊어냅니다.
2. 교착 상태 회피 (Prevention): 데드락 발생 자체를 원천 봉쇄하기 위해, 락 큐에 진입하기 전에 타임스탬프(트랜잭션 시작 시간)를 기준으로 우선순위를 매겨 통제하는 사전 조치 기법입니다.
| 기법 명칭 | 행동 원리 및 조건 | 상호작용 결과 |
| Wait-Die (늙은 트랜잭션 대기) | 요청자(New)가 점유자(Old)보다 우선순위가 높을(오래되었을) 경우 |
우선순위가 높은 요청자는 큐에서 점유자가 락을 풀 때까지 대기(Wait)합니다.
|
| 요청자(New)가 점유자(Old)보다 우선순위가 낮을(최근일) 경우 |
우선순위가 낮은 요청자는 대기하지 못하고 스스로 롤백하여 죽습니다(Die).
|
|
| Wound-Wait (젊은 트랜잭션 대기) | 요청자(New)가 점유자(Old)보다 우선순위가 높을(오래되었을) 경우 |
우선순위가 높은 요청자가 락을 탈취하고, 점유자에게 상처를 입혀 롤백(Wound)시킵니다.
|
| 요청자(New)가 점유자(Old)보다 우선순위가 낮을(최근일) 경우 |
우선순위가 낮은 요청자는 힘이 없으므로 얌전히 큐에서 대기(Wait)합니다.
|
결국 우리가 당연하게 누리고 있는 데이터베이스의 완벽한 무결성은, 2PL과 MGL이라는 훌륭한 법칙과 이를 0.001초의 오차도 없이 물리적으로 통제해 내는 락 매니저라는 엔지니어링 걸작이 만들어낸 합작품인 셈입니다.
글을 마치며
MGL은 다양한 Lock 대상을 공존시켜야 동시성 성능과 락 매니저(Lock Manager) 오버헤드에 따른 Trade-off를 적절히 조절할 수 있다는 개념을 제시하였습니다. 그리고 이를 실제로 가능케 한 것은 정밀하게 설계된 의도 락(Intention Lock)과 의도 락을 고려한 락 매니저(Lock Manager)의 구현일 것입니다.
지금 2PL과 MGL까지, DBMS의 직렬화를 보장하는 근간을 알아보았습니다. 그런데 사실 현대 데이터베이스에서는 이것들이 그렇게 중요하지 않을 수 있습니다... 다음 글에서는 MVCC를 깊게 다뤄보겠습니다.
'탐구 생활 > 데이터베이스' 카테고리의 다른 글
| 데이터베이스 Lock, 2PL(Two-Phase Locking) (0) | 2026.09.25 |
|---|---|
| 데이터베이스 Lock, 기본개념 (1) | 2026.09.20 |
| JOIN을 지웠더니 편안해졌다, Application-Level Join 실전 도입기 (0) | 2026.09.06 |
| MySQL vs PostgreSQL, 조인의 불확실성과 엔진별 한계 (0) | 2026.09.06 |
| RDB 복합인덱스 조금 깊게 알아보기 (0) | 2026.09.05 |