백엔드 개발을 하면서 RDBMS(MySQL, PostgreSQL)를 다루다 보면 DeadLock현상을 직접 마주하거나 혹은 코드리뷰 과정에서 DeadLock을 우려하는 리뷰를 받을 때가 있습니다. 그리고 DeadLock이라는 용어는 동시성을 다루는 소프트웨어를 개발자들에게 일상적인 용어입니다.
이 글을 쓰기로 마음먹은 날에 코드리뷰를 하면서 "이 테이블의 이 필드를 갱신하는게 DeadLock이 발생할지 한번 파악해보자"라는 이야기를 하고 있었습니다. 그러다 문득 깨달았습니다. 나는 RDBMS에서 DeadLock이 발생하는 매커니즘을 얼마나 이해하고 있을까? 그래서 RDBMS에서 Lock 에 대해 더 알아보았고, 데이터베이스 Lock에 대한 시리즈 글을 쓰기로 마음 먹었습니다.
데이터베이스 Lock에 대한 가벼운 이야기
데이터베이스 Lock에 대한 이야기를 하기전에 앞으로 이야기를 전개해나갈때 반드시 필요한 개념을 획득해야합니다.
Lock이 필요한 이유
지난번 인덱스를 설명할때 데이터베이스를 디스크에 데이터를 빨리 쓰고 빨리 퍼올리는 시스템이라고 정의했었습니다. 하지만 Lock을 설명할때는 다르게 정의하는게 이해가 쉬울것 같습니다.
데이터베이스는 보통 여러 요청을 동시에 처리하게 됩니다. 여기서 요청이란 읽기와 쓰기(데이터 생성, 수정, 삭제)로 나뉩니다. 이제 데이터베이스를 '동시에 읽기와 쓰기를 처리하는 시스템'이라고 정의해 보겠습니다. 동시에 읽기, 쓰기를 처리할 때 당연히 동시성 문제가 발생하고, 이러한 현상을 흔히 데이터베이스 동시성 제어 문제(Database Concurrency Anomaly)라고 부르고 아래의 다섯 가지 현상이 대표적입니다.
| 이상 현상 (Anomaly) | 설명 | 발생 원인 |
| Dirty Read (오류 읽기) |
다른 트랜잭션이 아직 커밋하지 않은(Uncommitted) 데이터를 읽는 현상. | 트랜잭션 A가 데이터를 수정 중인데, 트랜잭션 B가 변경 중인 해당 데이터를 읽어갈 때 발생. (이후 A가 롤백하면 B는 잘못된 데이터를 가진 상태가 됨) |
| Non-Repeatable Read (반복 불가능한 읽기) |
한 트랜잭션 내에서 같은 쿼리를 두 번 실행했을 때, 그 결과값이 다르게 나타나는 현상. | 트랜잭션 A가 데이터를 읽고 있는 도중, 트랜잭션 B가 해당 데이터를 수정(Update)하거나 삭제(Delete)하고 커밋했을 때 발생. |
| Phantom Read (유령 읽기) |
한 트랜잭션 내에서 같은 조건으로 쿼리를 두 번 실행했을 때, 처음에는 없던 데이터(유령 레코드)가 두 번째에 나타나는 현상. | 트랜잭션 A가 조건에 맞는 데이터를 조회하는 도중, 트랜잭션 B가 해당 조건에 부합하는 새로운 데이터를 삽입(Insert)하고 커밋했을 때 발생. |
| Lost Update (갱신 분실) |
두 개 이상의 트랜잭션이 동시에 같은 데이터를 수정할 때, 먼저 수정된 내용이 무시되고 나중에 수정된 내용만 남는 현상. | 트랜잭션 A와 B가 동시에 같은 데이터를 읽고 각각 수정 후 커밋할 때, B의 커밋이 A의 커밋을 덮어씌워버릴 때 발생. |
| Dirty Write (오류 쓰기) |
다른 트랜잭션이 아직 커밋하지 않은 데이터를 덮어쓰는 현상. | 트랜잭션 A가 수정한 데이터를 커밋하기 전에 트랜잭션 B가 덮어씌워 버릴 때 발생. |
이러한 Concurrency Anomaly 를 막기 위해 하나의 읽기, 쓰기에게 자원(데이터베이스)에 대한 점유권을 주는 것을 Lock이라고 합니다.
즉, Lock은 데이터베이스가 동시에 여러 읽기, 쓰기 요청을 처리할때 데이터 오염을 방지하기위해 필요합니다. 조금 어렵게 표현하자면 동시성 문제를 해결하기 위해 직렬성(Serializability) 을 확보하는 것이 Lock의 목표입니다.
직렬성(Serializability)이란?
병렬로 교차 실행된 트랜잭션 스케줄의 최종 결과가, 그 트랜잭션들을 임의의 순서로 하나씩 순차적(Serial)으로 실행했을 때의 결과와 수학적으로 완전히 동일함을 보장하는 성질을 의미합니다.
직렬 실행은 동시성 문제가 전혀 발생하지 않는 이상적인 상태이지만, 성능 측면에서 시스템 자원의 병렬 처리를 완전히 포기하는 것이므로 실무적으로 수용할 수 없는게 현실입니다.
Lock 의 종류
데이터베이스에서도 이는 마찬가지여서 두 가지 락 모드를 사용합니다.
- 공유 락 (Shared Lock, S): 데이터를 읽을 때 획득하며, 여러 트랜잭션이 동시에 S 락을 중복으로 가질 수 있지만, X 락 획득은 차단합니다.
- 배타 락 (Exclusive Lock, X): 데이터를 수정할 때 획득하며, 다른 트랜잭션이 S 락이나 X 락을 추가로 획득하는 것을 엄격히 금지합니다.
이 외에도 데이터베이스는 성능과 동시성의 균형(Trade-off)을 맞추기 위해 락의 단위를 쪼개는 '락 세분화(Lock Granularity)'기법을 사용하며, 이를 위해 의도 락(Intent Lock)이라는 개념을 도입합니다.
레코드(Row) 단위로 락을 걸면 동시성은 극대화되지만 수백만 건의 락을 관리해야 하므로 컴퓨팅 리소스가 고갈될 수 있고, 반대로 테이블(Table) 전체에 락을 걸면 오버헤드는 적지만 동시성이 심각하게 저하됩니다. 만약 어떤 트랜잭션이 스키마를 변경하거나 데이터를 통째로 삭제하려고 테이블에 배타 락(X)을 걸려 할 때, 하위 수백만 개의 레코드 중 하나라도 누군가 사용 중(S/X 락)인지 일일이 탐색(O(N))해야 한다면 엄청난 병목이 발생할 것입니다. 이러한 비효율을 O(1) 수준으로 즉각 판별하기 위해, 하위 레코드에 접근하기 전 상위 계층(테이블 등)에 '내가 곧 하위 데이터에 접근할 것이다'라는 미리보는 표지판(의도)을 남겨두는 것이 바로 의도 락입니다.
- IS (Intent Shared): 트랜잭션이 조만간 하위 계층의 노드 중 일부에 공유 락(S-Lock)을 획득하여 읽기 작업을 수행할 것임을 선언합니다.
- IX (Intent Exclusive): 트랜잭션이 하위 계층 노드 중 일부에 배타 락(X-Lock)을 획득하여 데이터 수정 작업을 수행할 것임을 선언합니다.
- SIX (Shared and Intent Exclusive): S 락과 IX 락이 결합된 형태로, 테이블 전체를 스캔(S 락)하면서 조건에 맞는 일부 레코드만 수정(IX 락)하는 배치 작업 등에서 락 처리 효율성을 높이기 위해 사용됩니다.
S-Lock, X-Lock 예시
그럼 아무런 락을 사용하지 않는 경우에는 어떻게 될까요?
한 가지 예시로 트랜잭션이 동시에 접근할 때 발생하는 문제를 설명해 보겠습니다.
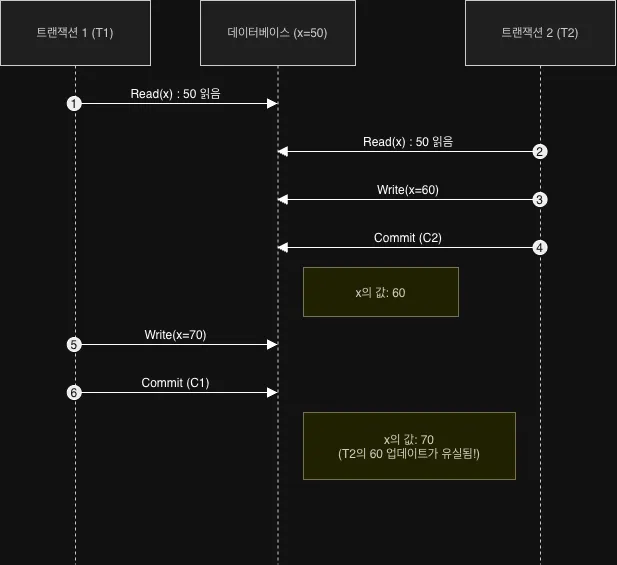
T1이 데이터 X를 읽고 70으로 업데이트를 준비하는 동안, 거의 동시에 T2 역시 X를 읽고 60으로 업데이트를 수행합니다. 그 결과 최종적으로 X의 값은 어떻게 될까요? 이는 트랜잭션이 커밋(Commit)되는 타이밍에 달려있으며, 결국 나중에 커밋된 값만 남고 먼저 커밋된 값은 덮어씌워져 유실되고 맙니다. (위 다이어그램의 예시에서는 T1이 나중에 커밋하여 최종적으로 70이 남고, T2의 업데이트 내역은 완전히 유실되었습니다.)
그럼 공유 락만을 사용하는 경우에는 어떻게 될까요?
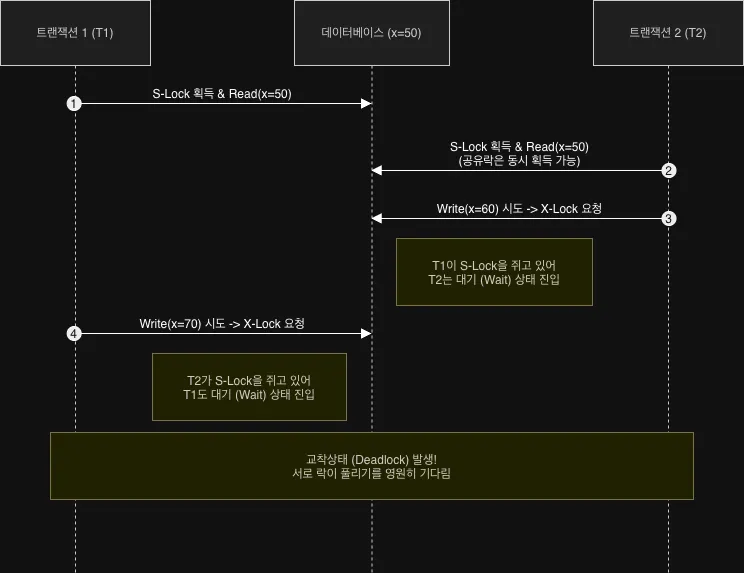
T1이 읽기를 할때 S-Lock을 획득하고, T2역시 읽기를 할때 S-Lock 을 획득합니다.T1이 이미 S-Lock 을 들고 있어서 T2 의 쓰기 요청은 대기(Wait)상태가 되고, T1의 쓰기 요청 역시 T2의 S-Lock에 의해서 대기상태가 되어 결국 DeadLock이 발생합니다.
그럼 배타 락만을 사용하는 경우에는 어떻게 될까요?
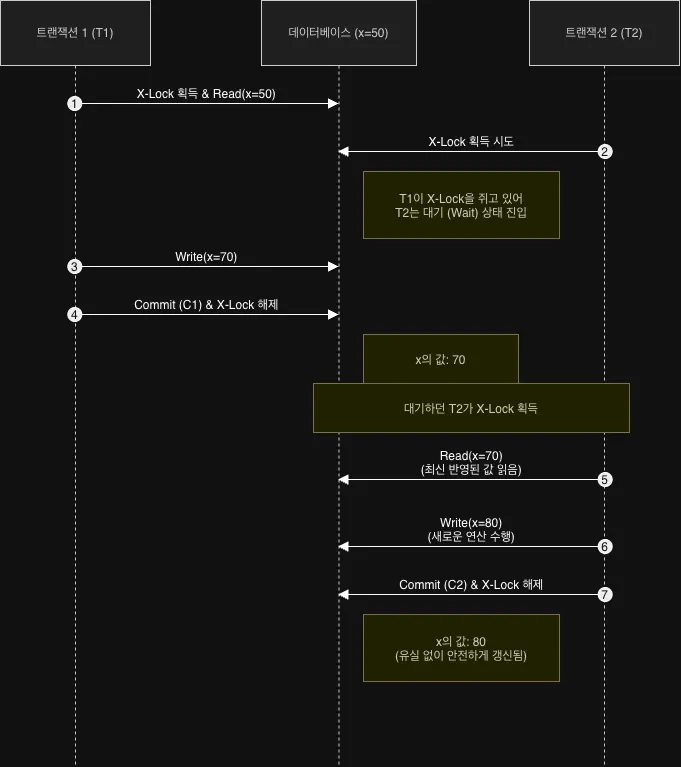
T1이 읽기를 할 때 처음부터 X-Lock을 획득하고, T2 역시 읽기를 위해 X-Lock 획득을 시도합니다. T1이 이미 X-Lock을 들고 있어서 T2의 접근 요청은 곧바로 대기(Wait) 상태가 되고, T1이 안전하게 쓰기 작업과 커밋을 마쳐 락을 해제한 후에야 대기하던 T2가 락을 획득하여 T1이 변경한 최신 값을 기반으로 작업을 수행하게 되어 결국 데이터 유실(Lost Update) 없이 안전하게 갱신됩니다.
Lock 과 격리 수준(Isolation Level)
사실 이러한 데이터베이스의 Lock은 우리가 흔히 알고 있는 데이터베이스의 ACID(Atomicity, Consistency, Isolation, Durability) 성질 중 격리성(Isolation)을 물리적으로 통제하는 핵심 수단입니다.
하지만 모든 동시성 문제를 순수하게 락(Lock)으로만 해결하려고 하면, 데이터를 읽고 쓰는 모든 과정에서 끝없는 대기(Wait)와 교착 상태(Deadlock)가 발생하여 시스템의 처리량이 심각하게 저하될 것입니다.
그래서 데이터베이스는 성능과 일관성 사이의 상충 관계(Trade-off)를 조율하기 위해 논리적인 엄격함의 단계를 나누었는데, 이것이 바로 격리 수준(Isolation Level)입니다. 즉, 격리 수준이 데이터베이스가 지키고자 하는 논리적 규칙이라면, 락(Lock)은 그 규칙을 물리적으로 강제하는 '제어 수단'인 셈입니다.
그런데 생각해 보면 우리가 실무에서 단순한 SELECT 쿼리를 날릴 때, 다른 트랜잭션의 UPDATE가 끝날 때까지 대기하는 일은 거의 없습니다. 앞서 설명한 락의 원리대로라면 S-Lock과 X-Lock이 충돌해서 무조건 기다려야 하는데 말이죠.
그 이유는 현대의 상용 RDBMS(PostgreSQL, MySQL 등)는 락으로 인한 대기열 병목을 피하기 위해 MVCC(다중 버전 동시성 제어, Multi-Version Concurrency Control)라는 아키텍처를 결합하여 사용합니다. 트랜잭션이 데이터를 수정할 때 덮어쓰지 않고 새로운 버전을 생성함으로써, 읽기 작업을 수행하는 트랜잭션은 락을 전혀 획득하지 않고 과거의 스냅샷을 읽어 들입니다. 결과적으로 읽기 연산이 쓰기 연산을 차단하지 않고, 쓰기 연산이 읽기 연산을 차단하지 않도록 락의 개입을 최소화하면서도 격리성을 유지하는 것입니다.
과거에 제정된 ANSI SQL 표준 격리 수준 표는 본래 Lock의 획득과 해제를 기준으로 만들어졌습니다. 하지만 현대의 RDBMS는 무작정 락을 거는 대신, 읽기 작업에는 MVCC(스냅샷)를 사용하고 쓰기 작업에만 선택적으로 락을 동원하는 하이브리드 방식을 통해 아래 표에 명시된 엄격한 규칙들을 지켜냅니다.
트랜잭션의 격리 수준을 설정하는 것은 결국 어떤 이상 현상(Anomaly)을 어디까지 허용하고, 락과 MVCC를 얼마나 엄격하게 적용할지 결정하는 과정입니다.
| 이상 현상 (Anomaly) | 설명 | 방지가능 최소 격리수준 |
| Dirty Read (오류 읽기) |
다른 트랜잭션이 아직 커밋하지 않은(Uncommitted) 데이터를 읽는 현상. | Read Committed |
| Non-Repeatable Read (반복 불가능한 읽기) |
한 트랜잭션 내에서 같은 쿼리를 두 번 실행했을 때, 그 결과값이 다르게 나타나는 현상. | Repeatable Read |
| Phantom Read (유령 읽기) |
한 트랜잭션 내에서 같은 조건으로 쿼리를 두 번 실행했을 때, 처음에는 없던 데이터(유령 레코드)가 두 번째에 나타나는 현상. | Serializable |
| Lost Update (갱신 분실) |
두 개 이상의 트랜잭션이 동시에 같은 데이터를 수정할 때, 먼저 수정된 내용이 무시되고 나중에 수정된 내용만 남는 현상. | Repeatable Read/Serializable, 또는 명시적 락(비관적/낙관적 락) |
| Dirty Write (오류 쓰기) |
다른 트랜잭션이 아직 커밋하지 않은 데이터를 덮어쓰는 현상. | Read Uncommitted |
기본 격리수준
DBMS는 따로 트랜잭션 격리수준을 설정하지 않으면 기본 격리수준을 제공합니다.
- PostgreSQL과 Oracle은 Read Committed
- MySQL(InnoDB)은 Repeatable Read
글을 마치며
이번 글에서는 데이터베이스에서 Lock이 왜 필요한지, 그리고 동시성 이상 현상(Concurrency Anomaly)과 격리 수준(Isolation Level)이 어떤 관계를 맺고 있는지 알아보았습니다. 이 정도만 알아도 일반적인 비즈니스 로직을 구현하는 데는 큰 무리가 없습니다.
하지만 제가 이 글을 쓰게 된 진짜 이유인 "실제 운영 환경에서의 DeadLock"을 예측하고 방어하기에는 아직 부족합니다.
다음 글에서는 단순한 S/X 락을 넘어, 데이터베이스가 락을 안전하게 관리하는 핵심 알고리즘인 2PL(Two-Phase Locking)과, 수백만 건의 트래픽 사이에서 병렬 처리 성능과 메모리 오버헤드 간의 줄다리기를 해결하는 Lock 세분화(Granularity), 그리고 현대 DBMS에서 동시성을 제어하는 방법인 MVCC를 차례대로 알아보겠습니다. 그리고 그 다음 편에서는 우리가 매일 다루는 MySQL(InnoDB)과 PostgreSQL이 이 이론들을 물리적으로 어떻게 다르게 구현하고 있는지까지 파헤쳐 보겠습니다.
'탐구 생활 > 데이터베이스' 카테고리의 다른 글
| 데이터베이스 Lock, MGL(Multiple Granularity Locking) (0) | 2026.09.25 |
|---|---|
| 데이터베이스 Lock, 2PL(Two-Phase Locking) (0) | 2026.09.25 |
| JOIN을 지웠더니 편안해졌다, Application-Level Join 실전 도입기 (0) | 2026.09.06 |
| MySQL vs PostgreSQL, 조인의 불확실성과 엔진별 한계 (0) | 2026.09.06 |
| RDB 복합인덱스 조금 깊게 알아보기 (0) | 2026.09.05 |