이 글에서는 이전에 다뤘던 S-Lock, X-Lock 을 개별 트랜잭션이 "어떻게" 획득하고 해제하는게 좋을지 그 방법을 다루는 Two-Phase Locking을 소개합니다.
트랜잭션의 충돌
이전 글에서 데이터베이스 Lock의 목적은 직렬성(Serializability)이라고 했습니다. 그런데 직렬성을 확보하기 위해 무분별하게 Lock을 걸면 트랜잭션들간에 충돌이 발생하기 마련입니다.
트랜잭션간 충돌이 일나는 시나리오는 제한적입니다. 락의 성격에 따라서 S-Lock끼리는 충돌이 일어나지 않구요, 오로지 S-Lock이 걸린 데이터에 대해서 X-Lock이 추가로 요구될때 혹은 X-Lock에 대해서 X-Lock이 추가로 요구될 때이죠. 조금 더 일반적으로 이야기하면 두 트랜잭션에 속한 두 개의 연산이 동일한 데이터 항목에 접근하고, 그중 최소 하나가 쓰기(Write, X-Lock) 연산일 때 두 연산은 충돌 쌍(Conflicting Pair)을 형성한다고 말합니다.
그럼 트랜잭션간 충돌은 왜 문제가 되까요? 모든 동시성을 다루는 시스템에서 충돌은 자연스러운 현상이지만, 충돌이 일어날때마다 Lock을 획득하기 위해 Wait이 발생한다는게 문제입니다.
첫째, 성능(동시성)이 급격히 저하됩니다. 하나의 트랜잭션이 락을 쥐고 놓지 않으면, 그 데이터를 필요로 하는 다른 트랜잭션들은 줄줄이 멈춰 서게 됩니다. CPU와 메모리는 남아도는데 DB는 일을 못하는 병목 현상이 발생합니다.
둘째, 더 치명적인 교착 상태(Deadlock)에 빠질 위험이 있습니다. 두 트랜잭션이 서로가 가진 락을 해제하기만 기다리며 영원히 멈춰버리는 끔찍한 상황이죠.
즉, 충돌을 안전하면서도 빠르게 처리할 수 있는 교통정리가 필요해집니다.
트랜잭션 충돌을 검증하는 방법, 선행 그래프
그래서 DBMS는 트랜잭션들을 스케줄링(Scheduling)합니다. 여기서 스케줄이란 여러 트랜잭션의 읽기/쓰기 연산들이 시간순으로 섞여서 실행되는 순서를 의미합니다.
만약 T1 트랜잭션이 완전히 끝난 뒤에야 T2를 실행한다면(직렬 스케줄) 데이터는 완벽히 안전하겠지만 DB 성능은 처참할 것입니다. 따라서 DBMS는 성능(동시성)을 극대화하기 위해 여러 트랜잭션의 연산을 아주 잘게 쪼개서 번갈아 가며 실행(Interleaving)시킵니다. 마치 교차로에서 교통경찰이 차들을 번갈아 통과시키듯 말이죠. 이 교통정리 과정이 스케줄링이며, 우리가 풀어야 할 숙제는 '어떻게 섞어서 실행(스케줄링)해야 충돌 없이 안전할까?를 검증하는 것입니다.
트랜잭션 충돌이 갖는 문제 때문에 특정 스케줄이 직렬 가능한지 판별하기 위한 수학적 모델링이 필요해졌습니다. 두 트랜잭션을 충돌 없이 스케줄링하는 것을 충돌 직렬성(Conflict Serializability)라고하며 이러한 충돌 직렬성을 검증하는 엄밀한 도구로 선행 그래프(Precedence Graph)가 자주 사용됩니다.
기초적인 선행 그래프는 아래와 같이 작성할 수 있습니다.

트랜잭션 충돌이 발생하는 경우 선행 그래프는 아래와 같이 그려집니다. T1, T2 노드간에 간선이 서로 생기는 싸이클이 만들어져버렸습니다.

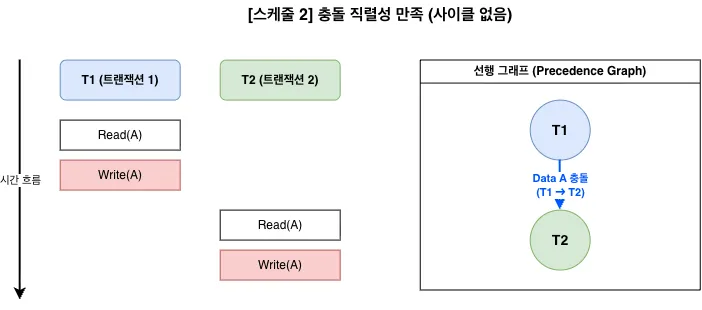
그리고 우리가 목표로 하는 충돌 직렬한 트랜잭션에 대한 선행 그래프는 아래와 같습니다.
충돌 직렬하게 만드는 알고리즘, 2PL(Two-Phase Locking)
하지만 트랜잭션이 들어올때마다 DBMS가 수 많은 연산을 바탕으로 동적 선행그래프를 그리고 사이클을 탐색하는 작업은 기하급수적인 오버헤드가 발생합니다. 따라서 선행그래프를 통해 충돌 직렬성을 검증하는 것은 연구로써 의미는 있을지라도 현실 세계의 DBMS에는 적합한 방법이 아닙니다.
이러한 이유에서 트랜잭션이 특정 규칙만 준수하면 구조적으로 사이클이 발생하지 않음을 보장하는 사전 통제 프로토콜이 필요해졌고, 데이터베이스의 거장 Jim Gray에 의해 2PL이라는 해법이 등장했습니다.
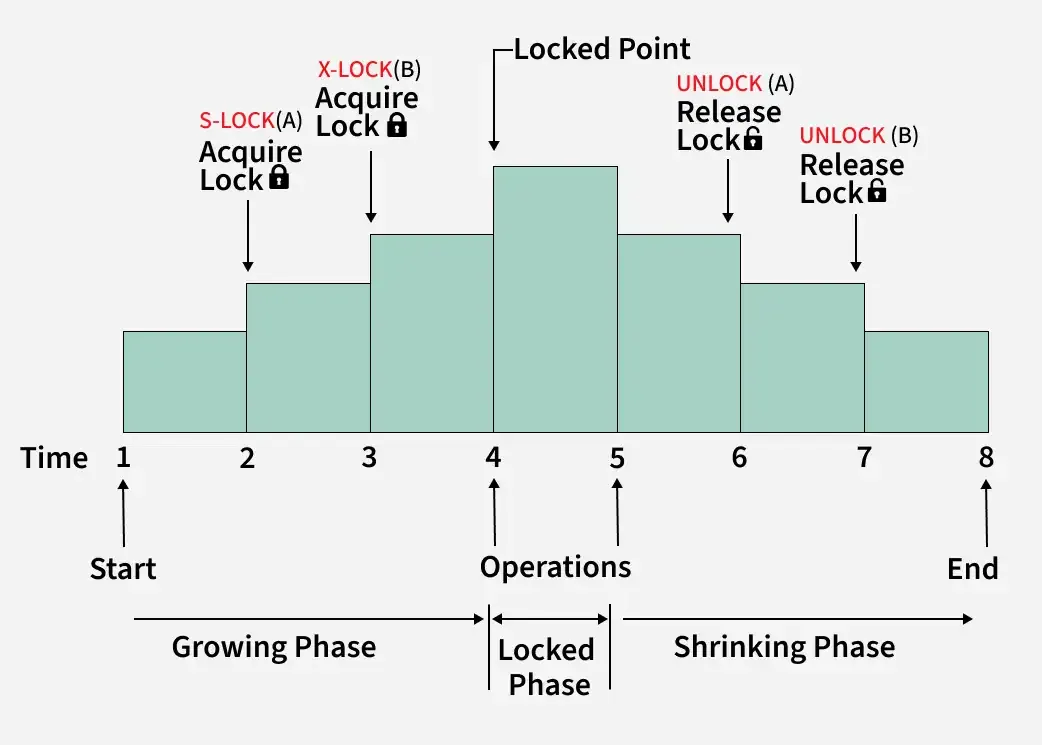
2PL의 아이디어는 정말 간단합니다. 트랜잭션이 Lock을 획득, 해제하거나 Lock을 승격(S->X), 격하(X->S)하는 단계를 확장단계와 수축단계로 엄밀하게 구분하고 각 트랜잭션이 이 단계만 지키면 충돌 직렬성이 확보된다는 것이죠. 아래 그림처럼 간단합니다.
2PL의 핵심 구성요소를 설명하자면
- 확장 단계(Growing Phase 또는 Acquisition Phase),
- 트랜잭션이 연산에 필요한 데이터 항목들에 대해 잠금(공유 락 또는 배타 락)을 지속적으로 획득하는 시기입니다.
- 이 단계에서는 새로운 락을 요청하고 부여받을 수 있지만, 보유 중인 락을 단 하나라도 해제하는 것은 엄격히 금지됩니다.
- 또한 공유 락(S)을 배타 락(X)으로 승격시키는 업그레이드(Upgrade) 연산은 오직 이 확장 단계에서만 허용됩니다.
- 두 번째는 수축 단계(Shrinking Phase 또는 Release Phase)
- 트랜잭션이 첫 번째 락을 해제하는 순간 트랜잭션은 즉시 수축 단계로 진입합니다.
- 이때부터는 보유한 락을 점진적으로 반환할 수 있으나 새로운 락의 획득은 전면 차단됩니다.
- 배타 락을 공유 락으로 낮추는 다운그레이드(Downgrade) 연산은 이 단계에서만 실행할 수 있습니다.
- 락 포인트(Lock Point): 트랜잭션이 가장 많은 수의 락을 보유하고 있는 시점, 즉 확장 단계가 끝나고 수축 단계가 시작되는 찰나의 순간을 의미합니다.
2PL의 충돌 직렬성 검증
정말 간단한 아이디어입니다. 이렇게 간단한 아이디어로 충돌 직렬성을 보장할 수 있을까요? 이것 역시 선행그래프로 증명해볼 수 있겠습니다.
2PL을 지킴에도 불구하고 충돌이 발생하는게 가능한지(귀류법) 선행 그래프로 아래와 같이 그려보겠습니다.
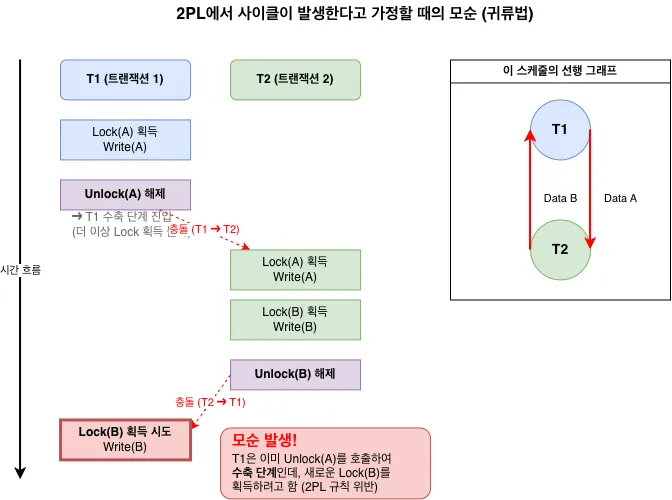
2PL에서는 Lock Point를 지나 수축 단계(해제)에 접어들면 절대 다시 확장 단계(획득)로 돌아갈 수 없습니다. 그런데 선행 그래프에 사이클이 생겼다고 가정해 보니, T1이 락을 푼(수축) 과거 시점보다 락을 얻는(확장) 미래 시점이 늦다는 시간적 역설이 발생합니다. 이것이 바로 2PL 규칙을 지키면 구조적으로 사이클이 생길 수 없는(충돌 직렬성이 보장되는) 수학적 이유입니다.
2PL의 연쇄 롤백 문제와 대안
2PL은 간단한 규칙으로 트랜잭션의 충돌 직렬성을 확보할 수 있게되었습니다. 그러면 현대 DBMS는 모두 2PL을 그대로 다를까요? 아쉽게도 2PL에는 치명적인 단점이 존재합니다. 바로 연쇄 롤백(Cascading Rollback) 문제입니다.
T1이 수축단계에 접어들어서 X-Lock을 해제했습니다. 이때 T2가 확장단계에서 X-Lock을 획독하고 연산에 들어갔습니다. 그런데 T1이 변경사항을 커밋(Commit)하기 전에 시스템 오류나 비즈니스 로직 위반으로 롤백(Abort)해야한다면? T1이 남긴 오염 데이터를 기반으로 연산한 T2 역시 함께 롤백되어야 합니다. 이러한 연쇄 롤백은 수많은 트랜잭션의 처리 자원을 낭비시키고 시스템 성능을 크게 저해하는 요소로 작용합니다.

현대 DBMS는 이러한 문제를 극복하기 위해 아래와 같이 변형된 2PL을 적용하고 있다. 상용 DBMS는 대부분 S2PL 또는 SS2PL 방식을 적용한다.
| 프로토콜 변형 | 적용 메커니즘 | 장점 및 특징 | 단점 및 한계 |
| Strict 2PL (S2PL) | 트랜잭션이 획득한 모든 배타 락(X-lock)을 수축 단계에서 점진적으로 해제하지 않고, 트랜잭션이 완전히 커밋(Commit)되거나 롤백(Abort)될 때까지 강제로 유지한다. | 커밋되지 않은 데이터의 읽기를 원천 차단하여 연쇄 롤백 현상(Cascading Abort)을 완벽하게 방지한다. | 공유 락(S-lock)은 조기 해제가 가능하므로 관리가 다소 복잡할 수 있다. |
| Strong Strict 2PL (SS2PL / Rigorous 2PL) | 배타 락(X-lock)뿐만 아니라 공유 락(S-lock)을 포함한 트랜잭션의 모든 락을 커밋이나 롤백 시점까지 끝까지 유지한다. | 구현이 매우 단순하며, 트랜잭션들이 커밋되는 순서와 정확히 일치하는 직렬화 순서를 보장한다. | 모든 락의 점유 시간이 극대화되므로 대기 시간이 길어지고 시스템 동시성이 상당히 저하된다. |
| Conservative 2PL (C2PL) | 트랜잭션이 시작되기 전에 실행에 필요한 모든 락의 목록을 사전에 선언하고, 이를 단일 단계에서 일괄적으로 획득한다. | 필요한 락을 모두 얻지 못하면 대기하므로, 점유와 대기(Hold and Wait) 조건이 성립하지 않아 교착 상태(Deadlock)를 원천적으로 방지한다. | 트랜잭션 실행 전에 접근할 데이터를 완벽히 예측하는 것은 현실적으로 불가능에 가까우므로 상용 시스템에서 실용성이 매우 떨어진다. |
DBMS 아키텍처와 락 매니저(Lock Manager)
이론적 모델인 2PL이 트랜잭션의 직렬성을 어떻게 보장하는지 확인했다면, 이제 이 추상적인 수학 모델이 CPU 코어와 메모리라는 제한된 하드웨어 자원을 가진 실제 컴퓨터 아키텍처 위에서 어떻게 동작하는지 분석할 차례입니다. 일반적인 현대 RDBMS는 다음과 같은 5단계의 계층적 아키텍처를 거쳐 쿼리를 처리합니다.
일반적으로 DBMS를 아래의 그림과 같이 구조화 합니다.
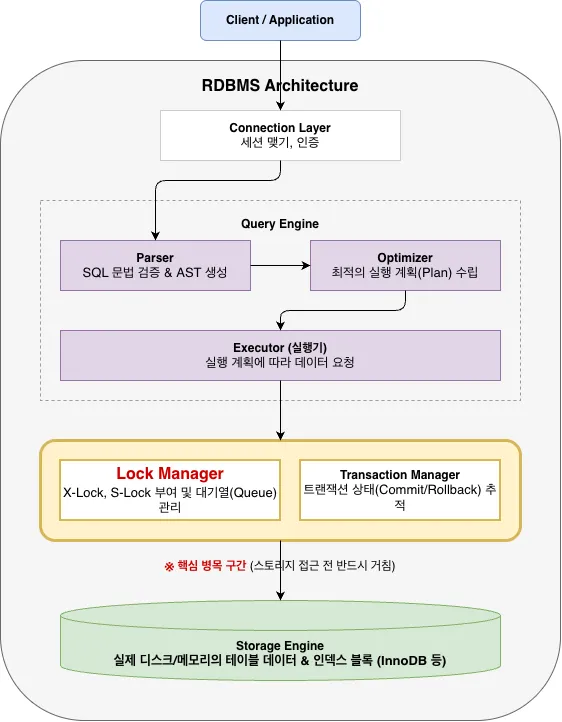
이 실행기와 스토리지 엔진 사이에 위치하여 모든 데이터 접근을 중재하는 핵심 모듈이 락 매니저(Lock Manager)와 트랜잭션 매니저가 존재합니다.
실행기가 특정 튜플을 수정(Write)하려고 할 때, 스토리지 엔진에 접근하기 전 반드시 락 매니저에게 해당 데이터 항목에 대한 X-Lock을 요청해야 합니다. 락 매니저는 운영체제의 공유 메모리(Shared Memory) 영역에 거대한 해시 테이블(Hash Table)을 구축해 두는데요, 이 해시 테이블에는 현재 어떤 프로세스가 어떤 데이터 객체에 대해 잠금을 쥐고 있는지, 그리고 누가 대기하고 있는지가 연결 리스트 형태로 촘촘히 기록되어 있습니다. 만약 요청한 데이터에 충돌하는 다른 잠금이 없다면, 락 매니저는 즉시 잠금을 부여하고 트랜잭션은 확장 단계를 이어간다. 반면 다른 트랜잭션이 이미 잠금을 선점했다면, 해당 프로세스는 스레드 컨텍스트 스위칭을 통해 운영체제 레벨에서 수면(Sleep) 상태로 전환되며 대기 큐(Wait Queue)에 편입됩니다.
락 매니저가 갖는 문제점, 락 스레싱
이 구조에서 컴퓨터 아키텍처 관점의 깊은 통찰이 필요합니다. 락 매니저가 글로벌 공유 메모리에 잠금 정보를 기록한다는 단순한 문장 이면에는, 멀티 코어 CPU 환경에서 벌어지는 치열한 물리적 자원 경쟁이 숨어 있기 때문입니다. 공유 메모리에 존재하는 단일 해시 테이블에 수십 개의 CPU 코어가 동시에 접근하여 포인터를 수정하려고 하면 심각한 데이터 손상이 발생할 수밖에 없습니다. 이를 막기 위해 락 매니저 자체도 해시 테이블에 접근할 때 상호 배제(Mutex)나 스핀락(Spinlock)과 같은 초저수준 래치(Latch)를 획득해야만 합니다.
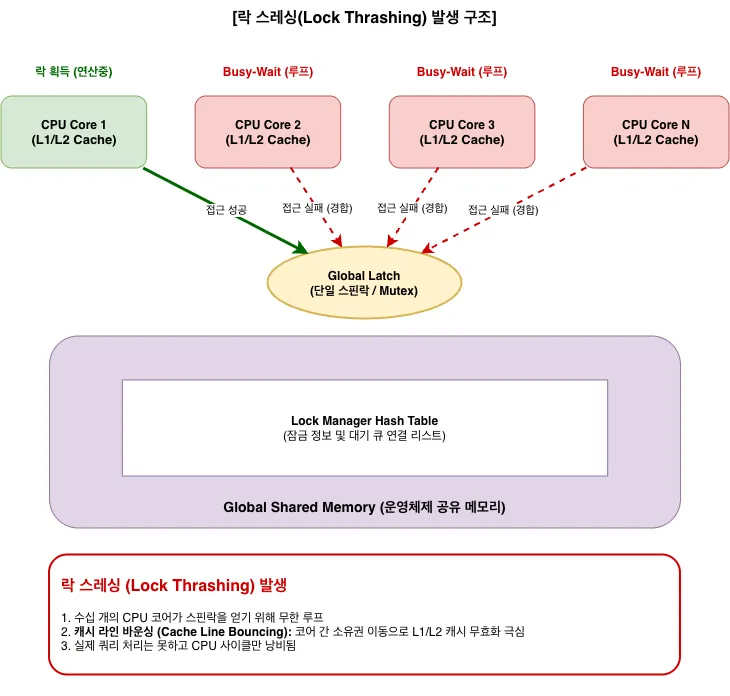
초당 수만 개의 쿼리가 쏟아지는 고동시성 환경에서는, 수십 개의 프로세스가 락 해시 테이블을 보호하는 단일 스핀락을 쟁취하기 위해 무한히 루프를 도는 Busy-wait 상태에 빠집니다. 이 과정에서 각 CPU 코어의 L1, L2 캐시 라인(Cache Line)이 무효화되고 소유권을 뺏고 빼앗기는 캐시 라인 바운싱(Cache Line Bouncing) 현상이 극심하게 발생합니다.
결과적으로 CPU는 실제 쿼리 연산이나 비즈니스 로직 처리는 전혀 하지 못한 채, 락 매니저의 상태를 동기화하는 데에만 막대한 사이클을 낭비하게 되며 이를 락 스레싱(Lock Thrashing)이라고 부르고 있습니다. 따라서 현대 상용 DBMS의 2PL 구현 핵심 과제는 어떻게 하면 수학적으로 완전한 2PL 규칙을 지키면서도, 글로벌 락 매니저로 향하는 병목 현상과 CPU 캐시 무효화를 최소화할 수 있을까?로 귀결됩니다.
오픈소스 DBMS의 대표격인 PostgreSQL과 MySQL은 이 문제를 패스트 패스와 뮤텍스 샤딩과 같은 방법으로 풀어냈습니다. 이 글에서 다루고 싶지만 그러면 내용이 너무 많아져서 다른 글에서 다루도록 하겠습니다.
글을 마치며
이번 글에서는 2PL라는 단순하지만 우아한 알고리즘이 RDBMS에서 트랜잭션간 충돌 직렬성을 어떻게 보장하는지 알아보고 현실 엔지니어링 레벨에서는 어떤 과제가 남아있는지 알아보았습니다.
개발자라는 직업을 선택하길 잘했다고 느껴지는 순간이 있습니다. 바로 이 글을 연재하는 과정인데요, 현실의 문제를 발견하고 문제 해결을 위한 이론과 엔지니어링 솔루션을 탐색한 뒤 실제 문제를 해결하는 이 과정에서 묘한 쾌감이 있습니다.
다음 글에서는 락 세분화에 대한 이론과 엔지니어링 솔루션을 알아보겠습니다.
'탐구 생활 > 데이터베이스' 카테고리의 다른 글
| 데이터베이스 Lock, MGL(Multiple Granularity Locking) (0) | 2026.09.25 |
|---|---|
| 데이터베이스 Lock, 기본개념 (1) | 2026.09.20 |
| JOIN을 지웠더니 편안해졌다, Application-Level Join 실전 도입기 (0) | 2026.09.06 |
| MySQL vs PostgreSQL, 조인의 불확실성과 엔진별 한계 (0) | 2026.09.06 |
| RDB 복합인덱스 조금 깊게 알아보기 (0) | 2026.09.05 |