
회사에서 실험적으로 LLM을 이용한 기능을 PoC하고 상용화까지 이끈 경험이 있습니다. PoC 단계의 결과가 나쁘지 않다면, 다음 스텝은 명확합니다. 정확도 지표를 만들어 품질을 관리하는 동시에 일반 고객들도 부담 없이 접근할 수 있는 수준으로 서비스 운영 비용을 낮추는 것입니다.
이 글은 그중에서도 백엔드와 인프라 관점에서 가장 중요한 '비용을 낮추는 작업'에 초점을 맞추고 있습니다.
LLM API의 과금 기준: '토큰(Token)'이란 무엇인가?
대규모 언어 모델은 우리가 입력하는 인간의 자연어를 텍스트 그대로 인식하지 않습니다. 컴퓨터가 이해할 수 있도록 텍스트를 고유한 정수 ID로 변환하여 처리하는데, 이때 모델이 정보를 처리하고 생성하는 가장 최소의 단위가 바로 '토큰(Token)'입니다.
토큰을 만드는 토크나이저(Tokenizer)의 알고리즘에 따라 하나의 토큰은 온전한 단어가 될 수도 있고, 단어의 일부(subword)가 될 수도 있으며, 심지어 단일 문자가 될 수도 있습니다.
토큰이 만들어지는 과정
유저의 프롬프트가 입력되고 응답이 돌아오기까지의 전체 과정은 아래 그림과 같습니다.

이 과정 중 텍스트가 토큰으로 변환되는 Tokenization(토큰화) 단계를 조금 더 깊이 살펴보겠습니다.

토크나이저 내부에서는 다음과 같은 작업이 순차적으로 일어납니다.
- UTF-8 Encoding: 입력된 텍스트를 가장 기본적인 단위인 UTF-8 바이트로 온전히 분해합니다.
- Pre-tokenization: 텍스트를 공백이나 구두점 단위로 1차 분리하여, 서로 다른 단어의 바이트들이 엉뚱하게 묶이는 것을 방지합니다.
- Vocabulary & BPE Mapping: 토크나이저가 내장하고 있는 어휘 사전(Vocabulary)을 참조하여, 쪼개진 바이트 중 가장 자주 등장하는 쌍(Pair)들을 순차적으로 병합합니다.
- ID Assignment: Subword들에 최종적으로 고유한 정수 ID(Token ID)를 부여합니다.
예를 들어 The quick brown fox jumps over the lazy dog. 는 프롬프트가 입력되면 아래와 같이 분리된 후 Prefill 단계를 거치게 됩니다.
Tokens: "The", " quick", " brown", " fox", " jumps", " over", " the", " lazy", " dog", "."
Token IDs: [976, 4853, 19705, 68347, 65613, 1072, 290, 29082, 6446, 13]
현대 LLM의 표준 알고리즘: BBPE
위 과정을 보면 UserPrompt에 대해서도 Tokenization 과정이 다르면 토큰 수가 달라진다는 것을 짐작할 수 있습니다.
단순히 텍스트를 공백이나 형태소 단위로 쪼개는 방식은 모델이 모르는 단어(OOV: Out-Of-Vocabulary)가 등장했을 때 대처하기 어렵습니다. 이 문제를 해결하기 위해 문자를 잘게 쪼개어 Subword로 만드는 BPE(Byte Pair Encoding)가 도입되었습니다. BPE는 본래 데이터 압축을 위해 자주 등장하는 데이터 쌍을 새로운 기호로 대체하는 알고리즘이었습니다.
여기서 한 단계 더 진화한 것이 GPT-2부터 도입된 BBPE(Byte-Level BPE)입니다. BBPE는 텍스트를 문자가 아닌 컴퓨터의 가장 기본 단위인 256개의 바이트(Byte)단위로 분해하고 시작합니다. 덕분에 이모지, 특수문자, 처음 보는 외계어까지 100% 분해하고 조립할 수 있는 강력한 범용 토크나이저가 탄생할 수 있었습니다.
오늘날 GPT, Claude(Opus), Gemini, Qwen 등 대부분의 최신 모델들은 동일한 텍스트에 대해 각기 다른 토큰 수를 산출하지만, 그 근간에는 모두 이 BBPE 알고리즘이 자리 잡고 있습니다.
내 프롬프트는 왜 이렇게 토큰을 많이 먹을까?
결국 '토큰 = 비용'입니다. 동일한 질문을 던져도 모델마다 청구되는 토큰량이 크게 달라질 수 있다는 것을 확인했습니다. 이 차이를 이해하려면, 모든 토크나이저의 핵심 엔진인 어휘 사전(Vocabulary)의 개념과 역할을 구조적으로 파악해야 합니다.
어휘 사전(Vocabulary)이란 무엇인가?
LLM의 어휘 사전은 쉽게 말해 '모델이 가지고 있는 한정된 개수의 레고 블록 세트'입니다.
- 블록의 종류: 어떤 블록은 "apple", "데이터"처럼 단어 전체가 통째로 만들어진 큰 블록이고, 어떤 블록은 "a", "가", 심지어 의미 없는 바이트(Byte) 조각 같은 가장 작은 1칸짜리 블록입니다.
- 토크나이저의 역할: 유저가 프롬프트를 입력하면, 토크나이저는 자신이 가진 '어휘 사전(레고 세트)'을 뒤져서 최소한의 블록 개수로 유저의 문장을 조립해 냅니다. 이때 사용된 블록의 개수가 바로 토큰 수가 됩니다.
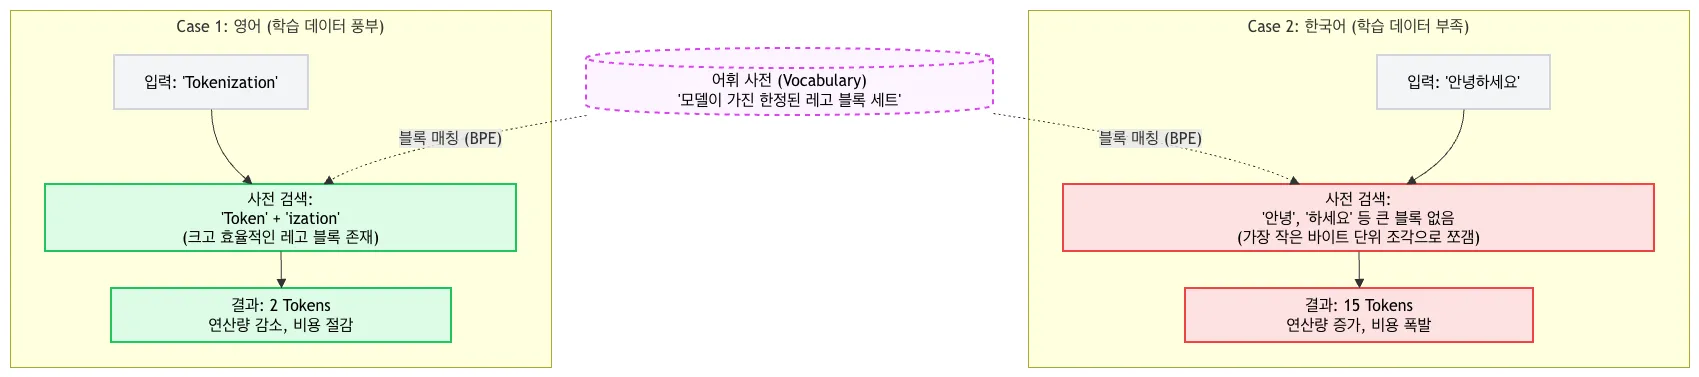
즉, 동일한 User Prompt에 대해 모델마다 토큰 수가 다른 이유는 각 모델이 훈련 과정에서 만들어낸 '어휘 사전의 크기와 구성(어떤 레고 블록을 가지고 있는지)'이 완전히 다르기 때문입니다.
혹시 이 설명만 들으면
어휘 사전(Vocabulary)은 어떻게 토큰의 양을 결정하는가?
그렇다면 모델들은 어떤 기준으로 자신만의 어휘 사전을 만들까요? 여기서 데이터 불균형과 다국어 편향성이라는 치명적인 문제가 발생합니다.
한정된 사전 크기 (Vocabulary Size)
모델의 어휘 사전 크기는 무한정 늘릴 수 없습니다. 사전의 크기(블록의 종류)가 커질수록 모델의 가중치(LM Head 레이어 등)가 비대해져 GPU 메모리 소비가 폭증하기 때문입니다. 따라서 한정된 공간 안에 가장 자주 쓰이는 문자열을 우선적으로 묶어서 큰 블록으로 만들어야 합니다.
학습 데이터의 편향성 (Data Bias)
Llama 3나 GPT-4 같은 범용 모델의 학습 데이터를 보면 95% 이상이 영어와 코드로 구성되어 있습니다. BBPE 알고리즘은 영어 문서를 압도적으로 많이 읽었기 때문에, 영어 단어들은 " token", "ization"처럼 큼직큼직한 블록으로 효율적으로 병합(Merge)해 사전에 등록해 두었습니다.
한국어 토큰 조각화(Fragmentation)
반면, 한국어는 학습 데이터 비중이 작아 토크나이저가 병합 규칙을 제대로 학습하지 못했습니다. 설상가상으로 영어 알파벳은 1바이트지만, 한글 완성형 글자는 UTF-8 인코딩에서 3바이트를 차지합니다. 사전에 한국어를 위한 '큰 블록'이 없다 보니, 토크나이저는 "안녕하세요"라는 짧고 의미 있는 5글자 단어를 조립하기 위해 아주 작은 바이트 단위의 1칸짜리 블록들을 긁어모아야 합니다. 그 결과, 단 하나의 단어가 무의미한 15개의 토큰(바이트 조각)으로 산산조각 날 수 있습니다.
단어가 파편화되어 하나의 문장이 너무 많은 토큰으로 분할되면, 텍스트의 정보 밀도가 떨어집니다. 모델은 동일한 의미를 생성하기 위해 더 많은 블록을 처리(추론)해야 하며, 이는 곧바로 시스템 지연(Latency)과 비용 폭발로 이어집니다. 우리는 이를 다국어의 저주(Curse of multilinguality)라고 부릅니다.
Qwen이 한국어 서비스에서 압도적으로 저렴한 이유
그렇다면 다국어 서비스, 특히 한국어 환경에서 어떤 모델을 선택해야 할까요? 여기서 Qwen 모델이 주목받는 이유가 등장합니다.
Llama 3나 GPT 계열은 영어를 고도로 압축하지만, 한국어 처리 시 병합 규칙이 무너지며 영어 대비 약 2.36배 더 많은 토큰을 소모하는 토큰 페널티를 겪습니다. 반면 Qwen은 구조적 설계 덕분에 이 비용을 극적으로 낮춥니다.
| 비교 항목 | 범용 모델 (Llama 3, GPT-4) | 다국어 최적화 모델 (Qwen) |
| 영어 토큰 압축률 | 매우 높음 | 높음 |
| 한국어 처리 방식 | 바이트 단위 파편화 발생 | 형태소 및 명사 단위 사전 병합 |
| 한국어 토큰 소모량 | 영어 대비 약 2.36배 | 영어 대비 약 1.1 ~ 1.3배 |
| 비즈니스 임팩트 | 한국어 서비스 시 비용 부담 가중 | 프리미엄 상용 API 대비 최대 60~80% 비용 절감 |
- 방대한 다국어 토큰 공간: Qwen은 151,643개라는 방대한 어휘 사전을 확보하고, 그 공간의 상당 부분을 CJK(한·중·일) 문자 체계에 할당했습니다.
- 형태소 단위의 병합 규칙:
"합니다","데이터","시스템"처럼 한국어에서 빈번하게 쓰이는 명사와 형태소들이 이미 단일 토큰으로 완성되어 있습니다. - 극대화된 압축 효율: 덕분에 한국어 텍스트 처리 시 토큰 팽창을 근본적으로 방어하여, 동일한 Workload에서도 실무적인 비용을 대폭 절감할 수 있습니다.
딥다이브, 어휘 사전은 컴퓨터의 '어디에' 있을까?
지금까지 어휘 사전(Vocabulary)이 토큰의 양을 결정하는 핵심 엔진이라고 설명했습니다. 그렇다면 우리가 서버를 띄워 LLM API를 서비스할 때, 이 토크나이저와 어휘 사전은 물리적으로 컴퓨터의 CPU와 GPU 중 어디에서 동작할까요? 흥미롭게도, 텍스트가 AI의 답변으로 변환되는 파이프라인을 따라가 보면 어휘 사전은 두 가지 다른 형태로 나뉘어 CPU와 GPU 모두에 존재합니다.
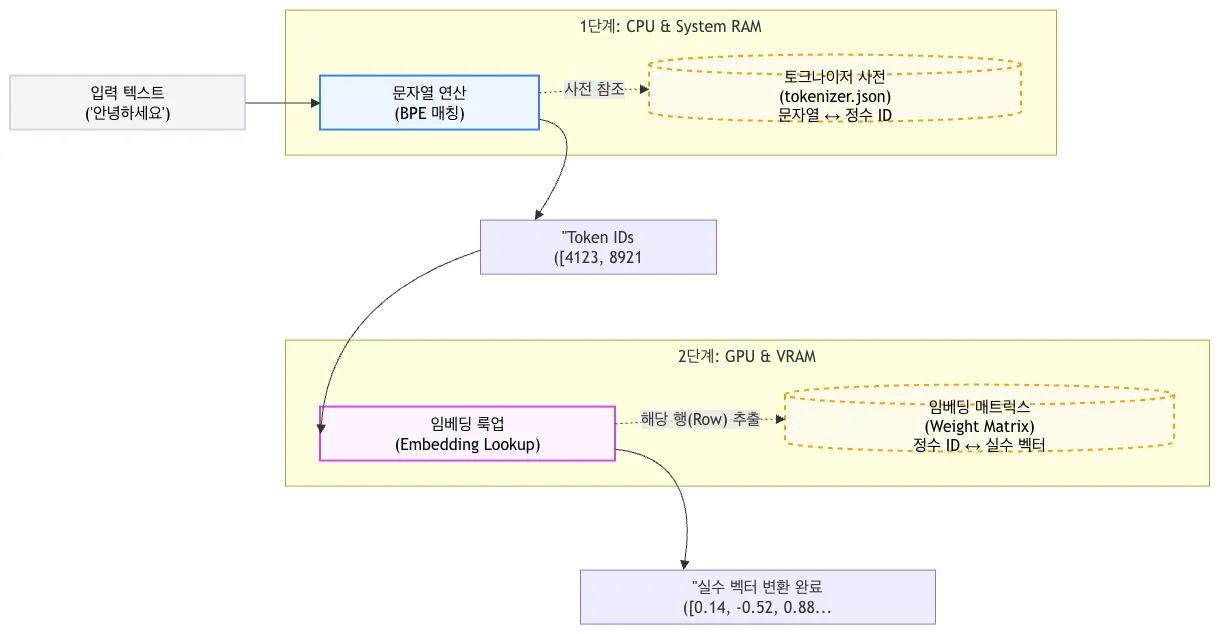
1단계: CPU와 System RAM (문자열을 정수 ID로)
UserPrompt "안녕하세요"가 입력될 때, 가장 먼저 일하는 곳은 CPU와 메인 메모리(System RAM)입니다.
- 물리적 형태: 이곳의 어휘 사전은 tokenizer.json과 같은 파일 형태로 메인 메모리에 적재되며, 내부적으로는 딕셔너리(Dictionary)나 해시맵 구조를 가집니다.
- 왜 GPU가 아닐까?: LLM은 GPU를 쓴다고 생각해서 GPU에 위치한다고 속단할 수 있습니다. 그런데 어휘사전의 작업은 텍스트의 공백을 자르고, 정규식을 돌리며, 바이트 단위로 쪼개어 매칭하는 작업은 순차적이고 가변적인 '문자열 처리'입니다. GPU는 거대한 행렬을 한 번에 곱하는 데는 괴물이지만, 이런 작고 복잡한 문자열 처리에는 굉장히 비효율적입니다.
- 결과물: CPU가 사전 매칭을 끝내면 텍스트는 [4123, 8921] 같은 정수 배열(Token IDs)로 변환되어 비로소 GPU로 넘어갑니다.
2단계: GPU와 VRAM (정수를 거대한 실수 벡터로)
CPU가 넘겨준 정수 ID를 GPU가 받았지만, 인공신경망은 소수점(Float)으로 이루어진 행렬 연산만 이해할 수 있습니다. 그래서 GPU의 VRAM 안에는 또 다른 형태의 거대한 어휘 사전이 대기하고 있습니다. 이를 임베딩 레이어(Embedding Layer)라고 부릅니다.
- 물리적 형태: 모델 가중치(Weight)의 가장 첫 번째 관문입니다. 이 행렬의 행(Row) 개수는 CPU가 가진 토크나이저 사전의 크기와 정확히 일치합니다.
- GPU의 역할: CPU가 `4123`이라는 ID를 던져주면, GPU는 VRAM에 있는 임베딩 사전에서 4123번째 행을 통째로 뽑아옵니다. 이 행은 `[0.14, -0.52, 0.88, ...]` 같은 거대한 실수 벡터이며, 이때부터 우리가 아는 본격적인 딥러닝 연산이 시작됩니다.
아키텍처 관점에서의 Trade-off (Qwen의 딜레마)
이 아키텍처 구조를 이해하면, 다국어 최적화를 위해 어휘 사전 크기를 약 15만 개로 대폭 늘린 Qwen 모델의 전략이 가진 Trade-off를 정확히 볼 수 있습니다.
- 장점 (토큰 수 최적화): 사전이 커서 큰 블록이 많으므로 텍스트가 적은 수의 토큰으로 쪼개집니다. 덕분에 내부 추론 사이클이 줄어들고, 지연 시간(Latency)과 과금 비용이 획기적으로 낮아집니다.
- 단점 (VRAM 점유율 증가): 사전 크기가 15만 개로 늘어났다는 것은, GPU VRAM에 올려야 하는 임베딩 레이어 행렬의 크기도 GPT나 Llama 3(약 5만~12만 개) 대비 훨씬 거대해진다는 뜻입니다. 즉, 모델을 서버에 띄우기 위해 기본적으로 요구되는 VRAM 메모리 용량이 커집니다.
결국 Qwen의 설계 철학은 모델을 처음 띄울 때 VRAM을 조금 더 쓰더라도, 실제 유저 트래픽이 쏟아질 때 발생하는 런타임(Runtime) 연산량과 토큰 비용을 극단적으로 줄이겠다는 전략적 선택인 셈입니다.
글을 마치며
무에서 Qwen을 도입한 결과, 다른 상용 모델 API를 이용할 때보다 텍스트 처리 비용을 95%나 절감할 수 있었습니다.
스타트업 환경에서 일하다 보면 "일단 빠르게 결과를 내어 비즈니스 가치를 증명(PoC)하고, 구조적인 유지보수나 최적화는 그 뒤에 한다"는 실용적인 접근 방식을 자주 취하게 됩니다. 이번 LLM 기능 도입 과정도 마찬가지였습니다. 처음에는 단순히 "한국어 학습 데이터가 많으니 한국어 처리에 더 저렴하겠지"라는 결과론적인 사실에만 기대어 최적화를 적용했습니다.
하지만 서비스가 궤도에 오르고 나니, 엔지니어로서 "정확히 어떤 원리가 이런 극적인 비용 절감을 만들어내는 걸까?" 하는 근본적인 호기심이 생겼습니다. 그 꼬리를 무는 질문들을 쫓아 조사하고 정리한 결과가 바로 이 글입니다.
이 글을 쓰기 위해 토크나이저의 파이프라인부터 어휘 사전의 물리적인 위치(CPU vs GPU)까지 파고들며, 퇴고하는 과정 속에서 제 스스로도 정말 많은 지식을 얻고 정리할 수 있어 무척 즐거웠습니다. "일단 되게 만드는 것"도 중요하지만, 가끔은 이렇게 한 걸음 멈춰 서서 '왜되지?' 를 치열하게 파헤치는 시간이 엔지니어를 한 단계 더 성장시키는 것 같습니다.
현업에서 LLM 서비스 상용화와 런타임 비용 최적화를 고민하고 계신 많은 개발자분들께, 저의 이 호기심과 고민의 과정이 작은 힌트가 되기를 바랍니다.
'탐구 생활 > AI' 카테고리의 다른 글
| 리뷰 퀄리티 판단 엔진을 만든 과정 (0) | 2026.08.30 |
|---|