RDB 복합인덱스 조금 깊게 알아보기
느린 쿼리를 마주한 백엔드 엔지니어의 첫 번째 반사 신경은 보통 인덱스 추가입니다. 하지만, 인덱스를 걸었는데도 쿼리 응답 속도가 꿈쩍도 하지 않거나, 되려 쓰기 성능(TPS)만 곤두박질치는 기이한 현상을 마주할 때가 있습니다.
이 글은 실제 이커머스 서비스의 트래픽을 처리하는 과정에서 발견한 잘못 설계된 복합 인덱스 한 줄에서 출발합니다.
인덱스가 B+Tree가 물리적으로 데이터를 정렬하는 방식(Lexicographical Order), PostgreSQL의 힙(Heap) 테이블 한계와 HOT(Heap-Only Tuple) 업데이트 파괴로 이어지는 나비효과까지, RDBMS 엔진의 밑바닥을 파헤쳐 보겠습니다.
겉보기엔 멀쩡한 인덱스의 함정
문제의 시작은 이커머스 도메인의 핵심인 OrderItem (주문 상품) 테이블이었습니다. 대시보드 조회가 느리다는 이슈를 해결하기 위해, 누군가 다음과 같은 인덱스를 추가해 두었습니다.
# Django Model Meta
indexes = [
    # ...
    models.Index(fields=["shop_id", "ordered_date", "product_id"]),
]
이 인덱스의 의도는 다분히 직관적입니다. "특정 쇼핑몰(shop_id)에서, 특정 기간(ordered_date) 동안 팔린, 특정 상품(product_id)을 조회하고 싶다." 필요한 컬럼을 빠짐없이 넣었으니 논리적으로 완벽해 보입니다.
하지만 이 인덱스는 B+Tree의 물리적 정렬 규칙을 정면으로 위반하고 있습니다. 데이터베이스 내부에서 이 인덱스가 어떻게 저장되는지 현미경을 들이대 봅시다.
PostgreSQL 이 인덱스를 타는 방식
The Internals of PostgreSQL을 보면, 인덱스는 논리적 집합이 아니라 사전식 정렬(Lexicographical Order)이 적용된 물리적 순열입니다. 복합 인덱스 (shop_id, ordered_date, product_id)는 각 노드에 이 세 가지 값의 튜플을 묶어서 정렬합니다.
등가 조건 탐색
문제는 앞선 컬럼의 값이 동일할 때만 뒤의 컬럼이 정렬된다는 점입니다. 흔히 말하는 최좌측 접두사 규칙(Leftmost Prefix Rule)입니다. 두 조건이 모두 등가(=)일 때, B-Tree는 목표물을 향해 완벽하게 수직 강하(Seek)하여 인접한 인덱스 튜플들을 순차적으로 읽어 들입니다.
(shop_id, product_id) 로 만들어진 index 가 존재하고, 해당 검색 조건으로만 데이터를 탐색하는 Equal 탐색 경우를 보겠습니다.
SELECT *
FROM orderitem
WHERE shop_id = 1
  AND product_id = 1;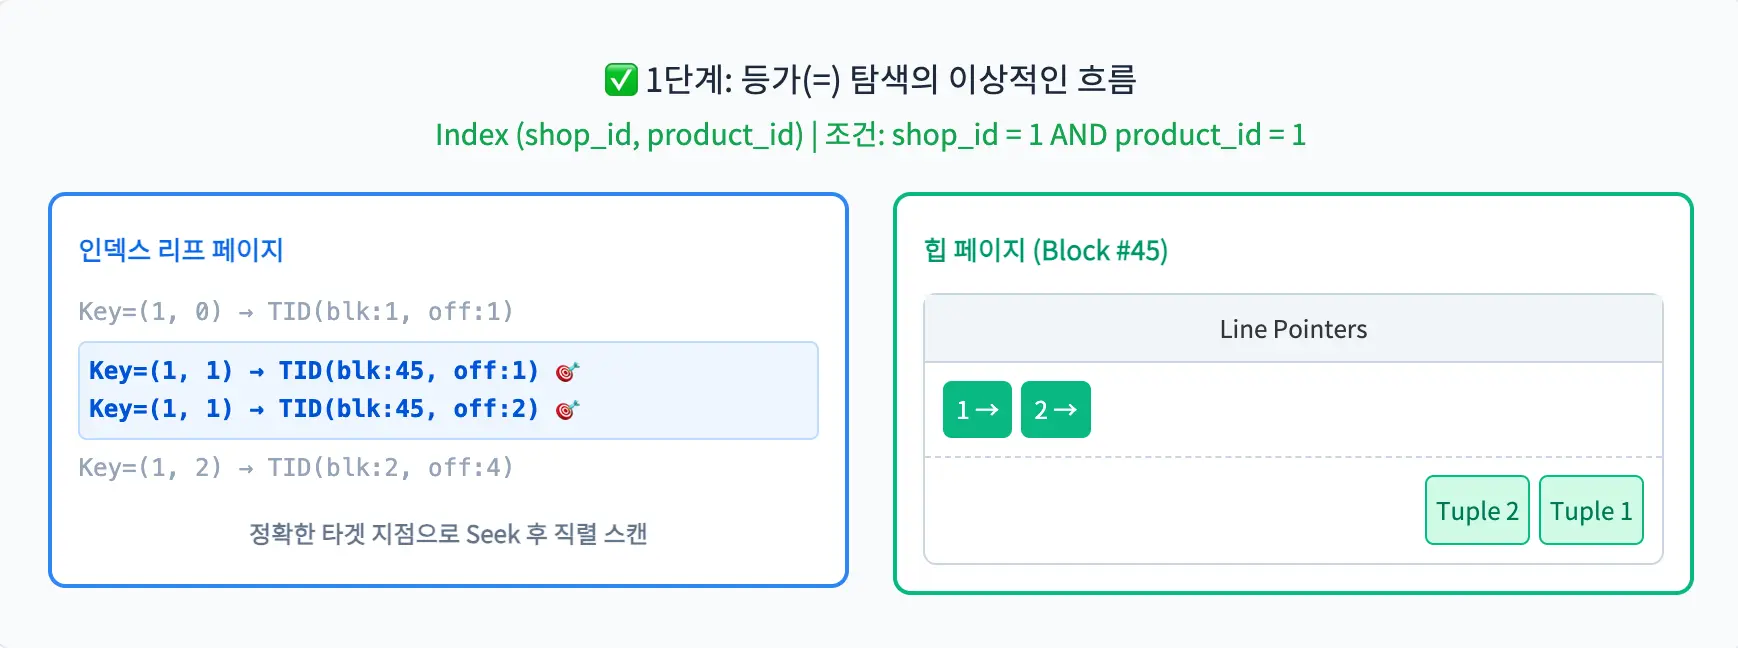
깔끔하게 TID 를 통해 빠르게 인덱스가 걸린 데이터를 탐색하고 목표가되는 block, offset 을 빠르게 탐색했습니다.
인덱스중간에 범위 탐색 조건이 낀경우
가장 흔하게 발생하는 안티 패턴입니다. 등가 조건(shop_id = 1)으로 시작했지만, 중간에 범위 조건(ordered_date >= ...)을 만나는 순간 인덱스 내에서 product_id의 정렬이 산산조각 납니다. (shop_id, ordered_date, product_id) 로 정의된 인덱스가 있는 경우입니다.
SELECT *
FROM orderitem
WHERE shop_id = 1
  AND product_id = 1
  AND ordered_date >= '2026-07-31 15:00:00+00'; -- 범위 탐색 조건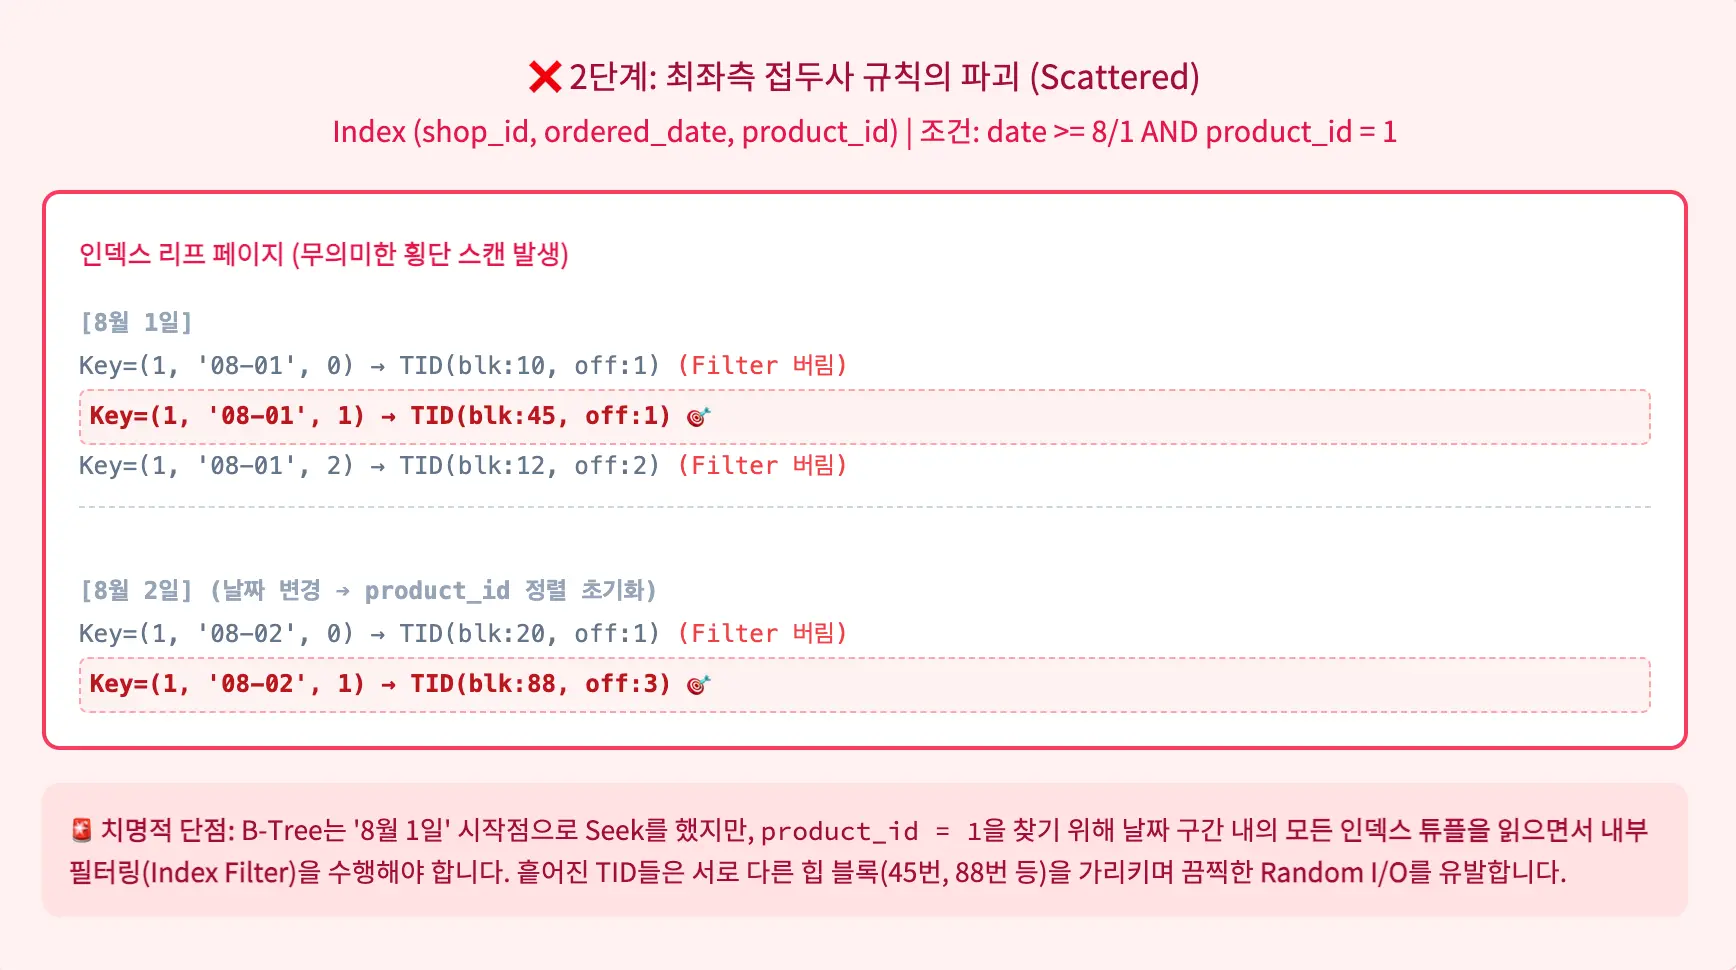
2026-08-01 지점으로 TID 에서 찾아낸(Seek)다음한 뒤, 그곳부터 리프 노드를 따라 우측으로 수평 스캔(Scan)을 시작합니다. 이때 우리가 진짜 찾고 싶은 product_id = 1 데이터를 찾기 위해 product_id의 정렬은 완전히 초기화되며 리프 노드 전체에 뒤죽박죽 흩어지게(Scrambled) 됩니다. 결국 DB 엔진은 인덱스의 탐색(Seek) 능력을 상실한 채, 해당 기간의 모든 상품 데이터를 읽어 들이면서 데이터베이스 메모리에서 product_id = 1인지 하나하나 필터링을 거쳐야만 합니다.
최좌측 접두사 규칙을 적용하기
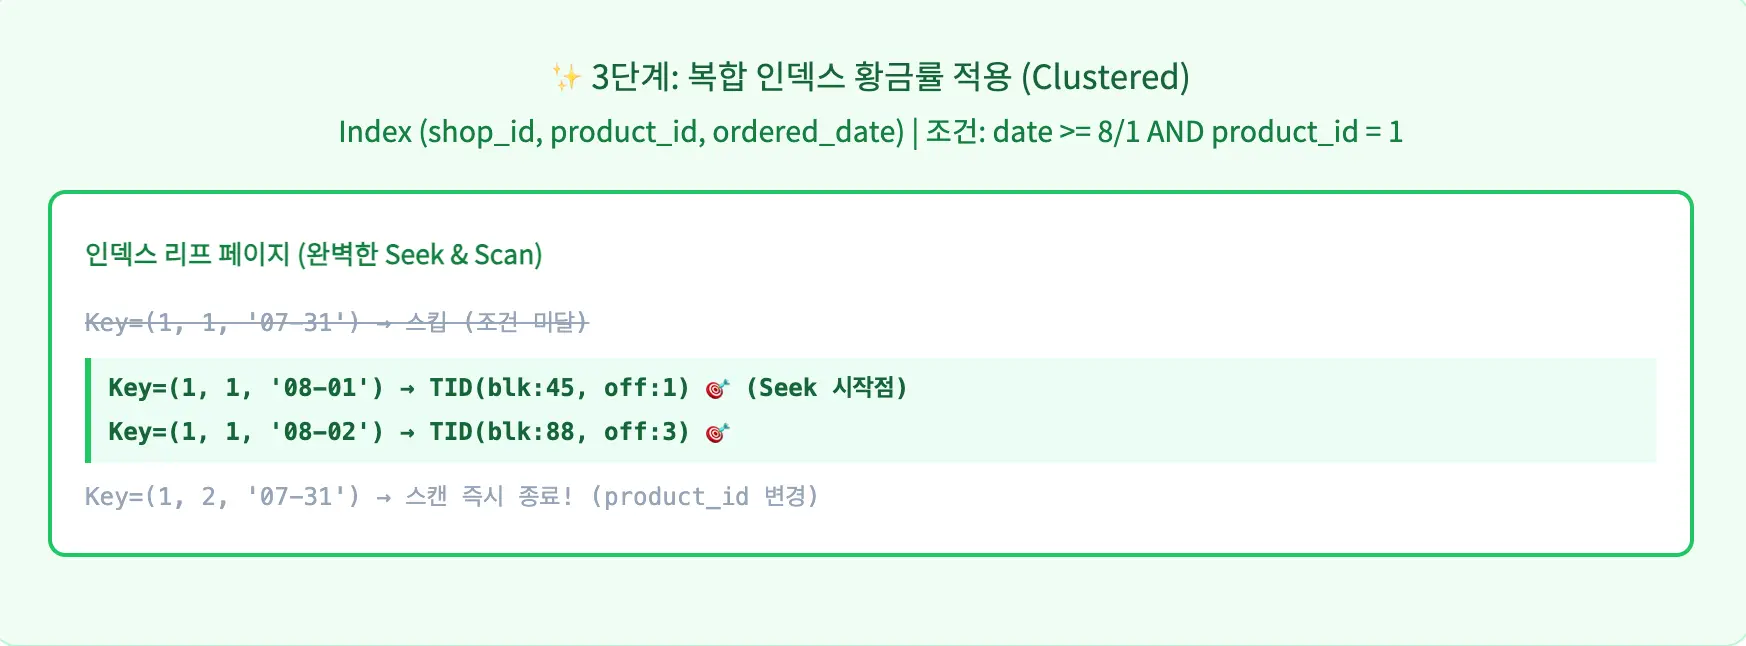
이런 문제를 해결하는 방법은 정말 간단하고 널리 알려져 있습니다. 바로 범위 검색 조건을 Index 마지막으로 보내는 겁니다.
(shop_id, product_id, order_date) 로 인덱스를 만들면 shop_id, product_id 가 연달아 등가 조건으로 묶이면서, PostgreSQL 엔진이 완벽하게 정렬된 인덱스 튜플 집합에서부터 데이터 튜플을 찾게됩니다.
복합 인덱스 설계의 황금률
범위(Range) 조건, 부등호, 정렬(ORDER BY)을 만나는 순간, 그 우측에 있는 컬럼들은 더 이상 B+Tree 탐색 키(Access Predicate)로 쓰이지 못합니다. 기껏해야 인덱스 내부 필터(Index Filter Predicate)로 전락합니다. 반드시 등가(=) 조건을 앞에, 범위/정렬 조건을 맨 뒤에 두어야 합니다.
실제 사례로 알아보기
이론을 실제 프로덕션 데이터로 검증해 보겠습니다. 특정 샵의 특정 상품에 대한 한 달 치 주문을 조회하는 쿼리입니다.
EXPLAIN (ANALYZE, BUFFERS)
SELECT *
FROM orderitem
WHERE shop_id = 1
  AND product_id = 1
  AND order_date >= '2026-07-31 15:00:00+00';
최좌측 접두사 규칙을 지키지 않은경우
Index Scan using ix_orderitem_bad on order_orderitem  (cost=0.57..68.41 rows=1) (actual time=14.319..140.760 rows=91 loops=1)
  Index Cond: ((shop_id = 1) AND (order_date >= '2026-07-31...') AND (product_id = 1))
  Buffers: shared hit=108 read=299
Execution Time: 140.873 ms
생각보다 나쁘지 않은것 같습니다? Index Scan 이 발생했고, Index Cond 에도 검색조건이었던 shop_id, product_id, order_date 세개가 모두 존재하네요. 인덱스를 잘 탄걸까요? 하지만 Index Cond는 DB가 인덱스 안에서 데이터를 걸러냈다는 뜻일 뿐, B+Tree를 수직 탐색했다는 의미가 아님에 주의해야합니다.
진실은 Buffers 지표에 있습니다. 고작 91건의 데이터를 찾기 위해 메모리와 디스크에서 무려 407개의 블록(hit 108 + read 299)을 뒤졌습니다. ordered_date 뒤에 흩어진 product_id를 찾느라 방대한 리프 노드를 횡단하며 140ms를 낭비한 것입니다.
최좌측 접두사 규칙 적용
이제 범위 조건인 날짜를 맨 뒤로 빼고 다시 측정해 봅니다.
Index Scan using ix_orderitem_good on order_orderitem  (cost=0.57..8.59 rows=1) (actual time=2.382..40.794 rows=91 loops=1)
  Index Cond: ((shop_id = 1) AND (product_id = 1) AND (order_date >= '2026-07-31...'))
  Buffers: shared hit=4 read=89
Execution Time: 40.865 ms
결과는 압도적입니다. 탐색해야 할 블록이 407개에서 93개로(약 77% 감소) 급감했습니다. B-Tree가 비로소 흩어져 있던 범위를 좁히고 목표물을 향해 정확히 다이빙(Seek) 해낸 것입니다.
(참고: 블록을 93개나 읽었는데도 실행 시간이 40ms가 나온 이유는, PostgreSQL이 데이터를 시간순으로 덧붙이는 힙(Heap) 테이블 구조이기 때문입니다. 91건의 데이터가 89개의 서로 다른 물리적 디스크 페이지에 흩어져 있어 Random I/O가 발생한 것이며, 캐시 웜업(Warm-up) 이후에는 메모리 Hit로 전환되어 수 ms 이내로 실행됩니다.)
글을 마치며
지금까지 복합 인덱스의 정렬 원리부터 PostgreSQL의 물리적 힙(Heap) 접근까지, 쿼리가 느려지는 근본적인 현상을 파헤쳐 보았습니다. 이 모든 긴 이야기를 B+Tree의 본질적인 동작 방식인 수직 탐색(Vertical Seek)과 수평 탐색(Horizontal Scan)이라는 두 가지 키워드로 요약하며 글을 맺고자 합니다.
수직 강하(Vertical Seek): 인덱스를 거는 가장 큰 이유는 O(log N)의 속도로 목표물을 향해 수직 강하(Seek)하기 위함입니다. 루트 노드에서 시작해 브랜치 노드를 거쳐 리프 노드의 정확한 시작점까지 단숨에 파고드는 이 과정은 데이터가 수천만 건이어도 눈 깜짝할 사이에 일어납니다. 그리고 이 수직 탐색을 가장 깊고 빠르게 만들어주는 것이 바로 등가(`=`) 조건입니다.
수평 횡단(Horizontal Scan): 하지만 조건절에 범위(>, <, BETWEEN)나 정렬(ORDER BY)이 등장하는 순간, 수직 강하는 멈춥니다. 엔진은 수직 강하를 멈춘 그 지점부터 리프 노드를 따라 우측으로 기나긴 수평 횡단(Scan)을 시작해야 합니다. 문제는 이 수평 횡단이 시작되는 순간, 그 우측에 정의된 컬럼들의 정렬은 무참히 깨진다는 것입니다. 날짜(Date) 구간을 수평으로 훑으며 지나갈 때, 상품 ID(product_id)는 끝없이 리셋되며 리프 노드 곳곳에 파편화(Scrambled)됩니다.
DB 엔진은 더 이상 수직 탐색을 하지 못한 채 흩어진 튜플들을 하나하나 열어보는 인덱스 내부 필터(Index Filter) 작업을 강행합니다. 그리고 이는 곧바로 PostgreSQL의 무자비한 Random I/O(Heap Fetch)나, MySQL의 무거운 북마크 룩업(Bookmark Lookup)으로 이어집니다.
다음번 CREATE INDEX문을 작성할 때는 마음속으로 B+Tree를 그려보시길 바랍니다. 나의 인덱스 컬럼 배치가 DB 엔진을 수직 강하하게 만들고 있는지, 아니면 광활한 수평선을 무식하게 걸어가게 강제하고 있는지 말입니다. 그리고 그 상상의 끝은 언제나 EXPLAIN (ANALYZE, BUFFERS)를 통한 철저한 계측이어야 합니다.